10. Алгоритмы на строках
10.1. Верёвка
Во многих языках и библиотеках строковый тип является массивом символов. Подобное представление в памяти логично, удобно, но неэффективно для операций конкатенации, вставки и некоторых других, ведь приходится выделять память под массив большего размера и переносить в него символы исходных строк за линейное время. Структура данных верёвка (rope, корд) позволяет обойти эту проблему. Это представление строки в виде бинарного дерева, в котором она хранится по частям, лежащим в листовых узлах. Каждый нелистовой узел дерева содержит длину подстроки, соответствующей левому дочернему поддереву. Целая строка собирается обходом листовых узлов слева направо.
Конкатенация (Concat) заключается в объединении двух деревьев новым корневым родительским узлом (рисунок 30). Сложность – , если полная длина верёвки хранится в корне. Иначе вес нового корня, равный длине всей левой части, приходится вычислять обходом правой ветви левого поддерева за .
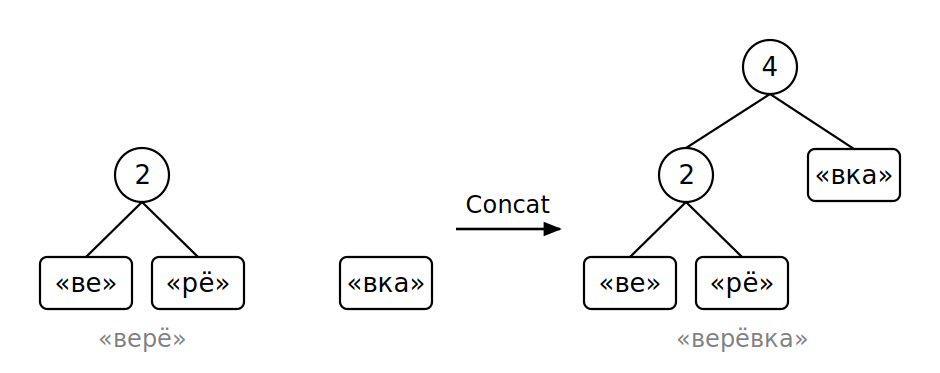
Отметим, что многократное присоединение коротких строк вырождает верёвку в подобие связного списка, после чего любой спуск по дереву деградирует до . Поэтому реализации либо периодически перестраивают дерево, либо опираются на самобалансирующиеся деревья. Все приводимые далее оценки предполагают сбалансированность.
Операция индексации, т.е. получения символа по номеру, реализуется путём спуска по дереву с переходом к относительным индексам в подстроке:
def index(node, i):
    # node.w - длина подстроки левого поддерева, node.s - строка листа
    if node - листовой узел:
        return node.s[i]
    if i < node.w:
        return index(node.left, i) # символ лежит в левой части
    # Спуск вправо: индекс отсчитывается от начала правой части
    return index(node.right, i - node.w)
Если искомый индекс меньше веса узла, символ лежит в левом поддереве и индекс не меняется. Иначе спуск идёт вправо, а индекс уменьшается на длину пропущенной левой части. Сложность индексации – .
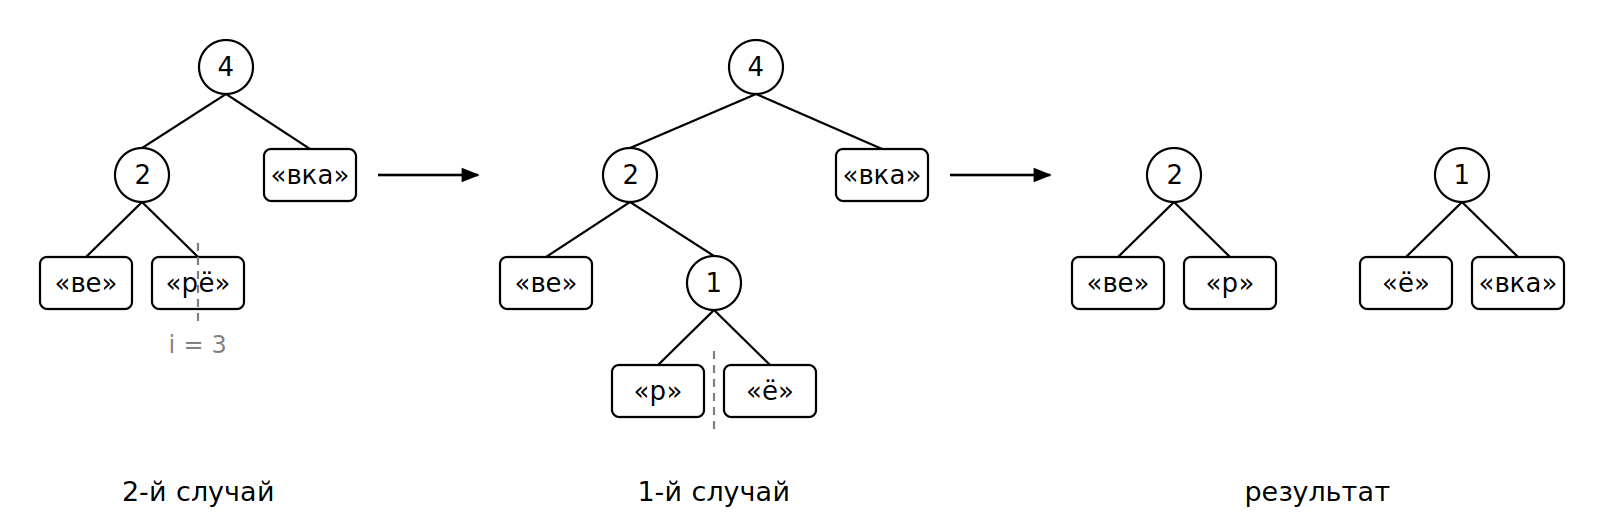
При разделении (Split) строки на две части по указанному индексу возможны два случая: 1) точка разбиения находится в конце строки листа и 2) точка разбиения находится в середине строки листа. Второй случай сводится к первому путём разбиения листового узла (и его строки) на два новых с созданием родительского. Для первого случая необходимо спуститься от корня к точке разбиения, сравнивая индекс с весом очередного узла точно так же, как при индексации. Поддеревья, остающиеся в стороне от пути спуска, целиком принадлежат одной из частей: при переходе в левого потомка правое поддерево отходит правой части, а при переходе в правого – левое поддерево отходит левой. Отложенные таким образом фрагменты остаётся собрать конкатенацией в порядке обхода, что и даёт две верёвки. Поскольку и длина пути спуска, и количество отложенных поддеревьев не превышают высоты дерева, сложность операции – . Весь ход разделения для второго случая, сводимого к первому, показан на рисунке 31.
Вставка подстроки по индексу осуществляется путём выполнения операции Split(i), а затем двух Concat: левой части с вставляемой подстрокой и результата с правой частью. Сложность операции – .
Удаление подстроки сводится к двум операциям Split по границам подстроки с последующей конкатенацией двух крайних частей. Сложность – .
Помимо эффективности в ряде операций преимущества верёвки по сравнению с обычными строками – в отсутствии требований к дополнительной памяти для выполнения операций (массивам она нужна для копирования). Однако обязательные траты памяти на представление выше из-за вспомогательных данных (узлы, ссылки), а также менее эффективны операции индексации и разделения. На малых строках недостатки перекрывают преимущества. Верёвка предпочтительна для очень длинных строк, которые постоянно меняются.
Ещё одно следствие древовидного представления – структурное разделение памяти. Копия верёвки или её части не копирует символы, а переиспользует те же самые поддеревья и узлы, поэтому снимок текущего состояния строки обходится в , а копия произвольного фрагмента – в . Для текстового редактора это фактически бесплатная история правок, а для многопоточного кода – возможность работать с неизменяемыми строками без блокировок.
Классические текстовые редакторы используют другие структуры: Emacs – буфер с разрывом (gap buffer); Word, VS Code – таблицу фрагментов (piece table). Эти структуры выигрывают, пока правки идут в одной точке, рядом с курсором. Верёвка же позволяет отдать снимок текста фоновому потоку (на подсветку синтаксиса или языковому серверу) без копирования и блокировок. Поэтому её выбирают современные редакторы на языке Rust: Xi, Helix и Zed. Верёвка также встречается в движках JavaScript (V8, JavaScriptCore), где результат конкатенации строк представляется именно ей. Новый узел хранит ссылки на операнды, а фактическая склейка символов откладывается до первого обращения, которое её потребует.
10.2. Препроцессинг и представление текста
В любых системах обработки текста одним из первых этапов выполняется препроцессинг, цель которого – подготовить данные для применения различных последующих алгоритмов. Типичные шаги конвейера препроцессинга: нормализация, токенизация, фильтрация, приведение слов к единой форме и, наконец, перевод текста в числовое представление, с которым уже работают алгоритмы.
Нормализация устраняет незначимые для задачи различия в написании: приведение к нижнему регистру, нормализация представления юникода, удаление или унификация пунктуации и диакритики. Для русского языка сюда же относится приведение «ё» к «е», иначе одно и то же слово в двух написаниях будет считаться двумя разными.
Токенизация – разбиение текста на элементарные единицы, токены. В классическом препроцессинге токенами выступают слова и знаки препинания, а задача сводится к расстановке границ между ними. Это сложнее, чем деление по пробелам: приходится учитывать сокращения, дефисные написания, числа, даты, адреса и т.д.
Удаление стоп-слов – это фильтрация частых, но неинформативных слов (предлоги, союзы, частицы и т.д.), чтобы сосредоточиться на ключевом содержимом. Обычно осуществляется по заготовленным спискам. Приём характерен для классического поиска, тогда как в современных системах, учитывающих контекст, он нередко вредит, поскольку меняет смысл фраз.
Для организации поиска по текстовым данным независимо от форм слов используется предварительный стемминг или лемматизация.
Стемминг – приведение слов к их основе (стемме) путём отсечения аффиксов, в первую очередь суффиксов и окончаний. Стемма не обязательно является допустимой словарной формой и не всегда совпадает с корнем. Для русского языка применяют алгоритм Snowball, учитывающий флективную морфологию. Примеры: бегающие – бега, машинами – машин, красивого – красив.
Лемматизация – более «умное» приведение к нормальной словарной форме (с учётом морфологии и контекста). Более сложна и вычислительно затратна, чем стемминг. Как правило, реализуется на основе словарей и предобученных ML-моделей; для русского языка это pymorphy3, MyStem, Natasha. В задачах анализа текста, извлечения различных признаков и более качественного поиска лемматизация предпочтительнее стемминга. Примеры: бегающие – бегать, машинами – машина, красивого – красивый.
Большинство современных техник работы с текстом (включая большие языковые модели) основаны на представлении текста в виде последовательности токенов, однако токен здесь понимается иначе: это не обязательно слово, а чаще его часть. Универсального алфавита токенов не существует, как правило, он формируется под задачу на основе анализа обучающих данных. Наиболее распространён алгоритм BPE (byte pair encoding): начиная с алфавита отдельных символов, он раз за разом находит самую частую пару соседних токенов и объединяет её в новый токен, пока словарь не достигнет заданного размера. В результате частые слова остаются целыми, а редкие распадаются на куски. Подсловные токены сами по себе устойчивы к словоформам, поэтому в нейросетевых пайплайнах стемминг и лемматизация практически не применяются, оставаясь инструментом классического поиска.
Подготовленный текст остаётся перевести в числа. Простейший способ описать его признаками – n-граммы, то есть последовательности из подряд идущих элементов. В зависимости от задачи элементами выступают символы (тогда из слова «текст» получаются триграммы «тек», «екс», «кст») либо целые слова. На n-граммах строят модели предсказания следующего слова, признаки для классификаторов, а также индексы приближённого поиска, о которых пойдёт речь далее.
Следующий шаг – мешок слов (bag of words): документ представляется вектором, где каждой позиции соответствует терм словаря, а значением служит число его вхождений. Для двух документов «Иван любит смотреть фильмы, Мария тоже любит фильмы» и «Иван также любит смотреть футбольные матчи» объединённый словарь даёт векторы (1, 2, 1, 2, 1, 1, 0, 0, 0) и (1, 1, 1, 0, 0, 0, 1, 1, 1). Порядок слов при таком представлении теряется полностью, зато документы становятся сравнимыми как точки одного пространства. Обычно частоты берут не напрямую, а взвешивают, чтобы частые и потому малоинформативные термы не перетягивали вектор на себя.
У мешка слов два неустранимых недостатка. Во-первых, размерность вектора равна размеру словаря, то есть десяткам и сотням тысяч, при том что ненулевых координат в конкретном документе единицы. Во-вторых, и это важнее, разные слова с близким смыслом оказываются просто разными координатами: «король» и «монарх» для такого представления ортогональны и не имеют друг к другу никакого отношения.
Эти недостатки снимают эмбеддинги – плотные векторы сравнительно небольшой размерности (обычно от сотен до тысяч), которые получают обучением модели на большом корпусе. Обучение устроено так, что близость векторов в пространстве отражает близость по смыслу, поэтому «король» и «монарх» оказываются рядом. Эмбеддинги строят на разных уровнях: для отдельных слов и токенов (статические Word2Vec, GloVe, FastText либо контекстные, учитывающие окружение, вроде BERT), для предложений (Sentence-BERT) и для документов целиком. Именно в пространстве эмбеддингов затем ищут ближайших соседей, а на этом, в свою очередь, строится семантический поиск. Отметим, что два представления не вытесняют друг друга, а дополняют: разреженное точнее ловит совпадение конкретных терминов, имён и артикулов, плотное – близость по смыслу, поэтому на практике их часто комбинируют.
10.3. Поиск подстроки
Пусть даны образец длины и текст длины . Требуется найти позицию, начиная с которой образец входит в текст, либо установить, что вхождений нет.
Прямолинейное решение прикладывает образец к каждой позиции текста и сравнивает посимвольно. При несовпадении образец сдвигается на одну позицию. Это в худшем случае даёт операций. Худший случай требует, чтобы текст и образец состояли из длинных повторяющихся кусков, а на естественных текстах несовпадение обнаруживается на первом-втором символе, и поведение оказывается близким к линейному. Вдобавок у наивного алгоритма есть три достоинства: он не требует предварительной обработки образца, не тратит памяти на таблицы и обращается к памяти строго последовательно. Последнее позволяет задействовать векторные инструкции процессора: вместо посимвольного сравнения за один такт сопоставляются сразу 16–32 байта текста с первым и последним символами образца, а полная проверка выполняется лишь для немногих уцелевших позиций. Именно так устроен String.indexOf в Java. Риск худшего случая при этом можно закрыть переключением на другой алгоритм, если наивный часто промахивается.
Алгоритм Кнута-Морриса-Пратта (КМП) опирается на префикс-функцию образца. Это длина наибольшего собственного (не равного всей подстроке) префикса, который одновременно является её суффиксом. Она рассчитывается для каждой позиции образца. Например, для образца ABCABD префикс-функция равна 0, 0, 0, 1, 2, 0. Зная её, при несовпадении можно сдвинуть образец сразу на столько позиций, чтобы уже совпавшая часть снова легла на текст правильно, а не начинать сравнение заново. Ни один символ текста при этом не читается дважды, отсюда гарантированная сложность . Алгоритм идёт по тексту строго вперёд, а потому применим к потоку данных, который нельзя перемотать. Однако на практике алгоритм проигрывает альтернативам и в промышленном коде не встречается. Сама префикс-функция полезна и за пределами поиска: через неё вычисляют наименьший период строки и проверяют её на периодичность.
Алгоритм Бойера-Мура сравнивает образец с текстом справа налево и при несовпадении сдвигает его сразу на несколько позиций. Величина сдвига берётся как максимум из двух эвристик, заранее посчитанных по образцу. Таблица стоп-символов подсказывает, на сколько сдвинуть образец, чтобы не совпавший символ текста встал под такой же символ образца. Таблица суффиксов подсказывает, на сколько сдвинуть образец, чтобы уже совпавший суффикс совпал со следующим своим вхождением. В результате часть символов текста не просматривается вовсе, и на практике алгоритм ведёт себя сублинейно: чем длиннее образец и чем больше алфавит, тем крупнее шаги. Именно поэтому он лёг в основу большинства реальных реализаций поиска.
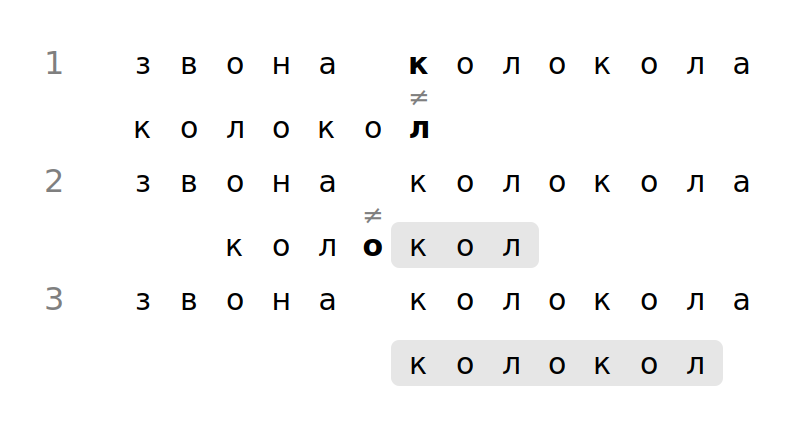
Для образца «колокол» таблица стоп-символов выглядит так: «л» – 2, «к» – 4, «о» – 5, а прочие символы в образце не встречаются. На рисунке 32 показаны три положения этого образца при поиске в тексте «звона колокола». Серым цветом отмечен уже совпавший суффикс, а знаком – место несовпадения. В первом положении несовпадение случается сразу на последнем символе образца, и поскольку не совпавший символ текста «к» встречается в образце на позиции 4, образец сдвигается на две позиции. Во втором три символа справа уже совпали, а не совпавший символ текста (пробел) в образце отсутствует вовсе, поэтому образец перепрыгивает за него целиком. Третье положение даёт совпадение: весь текст пройден за три прикладывания образца вместо семи у наивного алгоритма.
Отметим, что таблица суффиксов заметно сложнее в построении, а выигрыш даёт скромный. Поэтому распространённые упрощения алгоритма, вроде Бойера-Мура-Хорспула и Санди, от неё отказываются и обходятся одними стоп-символами. Именно такие варианты чаще всего и встречаются в реализациях.
Алгоритм Ахо-Корасик решает другую задачу – множественный поиск, когда в тексте нужно одновременно найти вхождения всех строк заданного словаря. Прямолинейное решение, то есть цикл по словарю с отдельным поиском каждой строки, обходится в операций, где – количество слов в словаре. При словаре в десятки тысяч записей это уже неприемлемо. Ахо-Корасик же просматривает текст ровно один раз независимо от размера словаря.
Из словаря строится бор, после чего к каждому его узлу добавляется суффиксная ссылка – на узел, соответствующий наибольшему собственному суффиксу строки, накопленной на пути от корня. Смысл ссылки в том, что при несовпадении не нужно возвращаться в начало текста: уже прочитанный хвост может оказаться началом другого слова словаря. Ссылки вычисляются обходом бора в ширину, поскольку ссылка потомка ищется от ссылки родителя, а та к этому моменту уже известна. Получившаяся конструкция – конечный автомат, которому текст подаётся по одному символу.
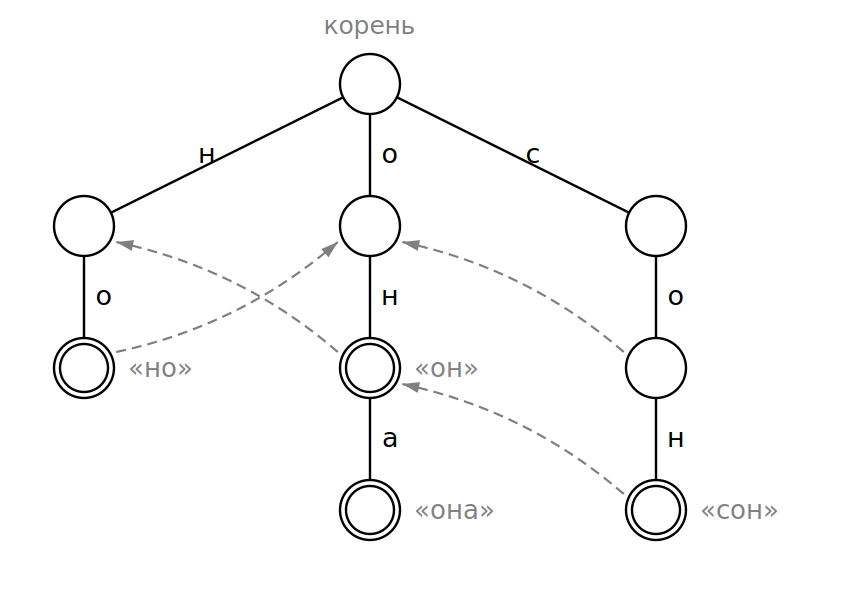
На рисунке 33 показан автомат для словаря из четырёх слов. Терминальные узлы выделены двойной окружностью, а суффиксные ссылки, ведущие в корень, не нарисованы, чтобы не засорять схему. Проследим обработку текста «сонно». Первые три символа ведут автомат по рёбрам «с», «о», «н» в терминальный узел, то есть найдено слово «сон». Суффиксная ссылка этого узла указывает на терминальный узел «он», значит, в той же позиции заканчивается и второе слово словаря. Следующий символ «н» перехода не имеет, поэтому автомат соскальзывает по суффиксным ссылкам до корня и переходит по символу «н». Последний символ «о» приводит в терминальный узел «но». Итого три вхождения за один проход по тексту:
def search(text, root):
    node = root
    for i = 0; i < len(text); i++:
        c = text[i]
        # Соскальзываем по суффиксным ссылкам, пока нет перехода по символу c
        while node != root and у node нет перехода по c:
            node = node.suffix
        if у node есть переход по c:
            node = node.children[c]
        # В узле заранее собран список слов, заканчивающихся в этой позиции
        for each word из node.outputs:
            сообщить о вхождении word на позиции i - len(word) + 1
Внутренний цикл соскальзывания не меняет линейность: каждый его шаг уменьшает глубину текущего узла, а увеличивается она только при переходе вперёд, поэтому суммарно соскальзываний не больше, чем прочитанных символов. Построение автомата занимает , где – суммарная длина слов словаря, а поиск – , где – количество найденных вхождений. Список outputs в узле хранится готовым, иначе при каждом совпадении пришлось бы проходить цепочку суффиксных ссылок до корня.
Множественный поиск встречается очень часто: сопоставление URL с набором правил маршрутизации, блокировщики рекламы с фильтр-листами, сигнатуры антивирусов и систем обнаружения вторжений, разметка текста по словарю терминов, поиск ключевых слов в потоке логов. Во всех этих случаях наивный перебор словаря даёт квадратичную зависимость там, где достаточно одного прохода.
Библиотечные реализации поиска подстроки, как правило, являются гибридными алгоритмами. memmem в glibc использует двусторонний алгоритм Крошемора-Перрена, str.find в CPython – упрощённый вариант Бойера-Мура-Хорспула с фильтром Блума, а grep и ripgrep комбинируют идеи Бойера-Мура и Ахо-Корасик с векторными инструкциями процессора.
10.4. Регулярные выражения
На практике часто требуется найти в тексте не заданную строку, а строку заданного вида: дату, адрес электронной почты, номер телефона, идентификатор в логе. Для описания таких множеств строк служат регулярные выражения – компактный язык шаблонов, поддерживаемый практически всеми языками программирования и текстовыми утилитами.
Выразительные средства у всех реализаций примерно одни и те же: классы символов (\d, [а-яё]), квантификаторы повторения (*, +, ?, {2,4}), альтернатива (|), группировка ((...)) и якоря начала и конца строки (^, $). Например, шаблон ^\d{4}-\d{2}-\d{2}$ описывает дату в формате ISO, а (\w+)@(\w+)\.(\w+) – простейший адрес электронной почты с выделением трёх групп.
За компактной записью стоит теория автоматов. Классическое регулярное выражение переводится в недетерминированный конечный автомат (построение Томпсона) за время, линейное по длине шаблона, а тот, в свою очередь, может быть преобразован в детерминированный. Детерминированный автомат обрабатывает каждый символ текста за константное время, поэтому поиск занимает время, линейное по длине текста, независимо от сложности шаблона. По сути это тот же приём, что и в алгоритме Ахо-Корасик, только автомат строится не по словарю, а по выражению.
На практике, однако, движки регулярных выражений делятся на два семейства:
- автоматные (RE2 в Google, стандартная библиотека Go,
regexв Rust) – строят автомат и гарантируют линейное время, но не поддерживают обратные ссылки и просмотр вперёд/назад; - с возвратом, backtracking (PCRE, Perl, Python, Java, JavaScript) – перебирают варианты сопоставления с откатом, поддерживают богатый синтаксис, но в худшем случае работают экспоненциально долго.
Пример худшего случая с экспоненциальной асимптотикой: шаблон (a+)+$ на строке из тридцати символов a, за которыми следует b. Совпадения нет, но перебрать движку придётся все способы разбиения тридцати символов на группы. Атака, эксплуатирующая это свойство, называется ReDoS, и для защиты от неё необходимо не подставлять пользовательский ввод в шаблон, ограничивать время выполнения и по возможности использовать автоматный движок. В 2019 году из-за ReDoS и вызванной ей перегрузки процессоров у Cloudflare миллионы сайтов обрушились примерно на полчаса.
Регулярные выражения описывают регулярные языки, а потому принципиально не способны проверять произвольную вложенность конструкций: сбалансированность скобок, корректность HTML или JSON регулярным выражением не разобрать. Для таких задач нужен парсер. Из практических же советов главные два: компилировать шаблон один раз и переиспользовать, а не собирать его в цикле, и ставить якоря ^ и $, если совпадение должно покрывать строку целиком, иначе проверка формата легко пропустит мусор до или после нужного фрагмента.
10.5. Нечёткий поиск
Нечётким называют приближённое сравнение строк, что необходимо при выявлении опечаток или сопоставлении объектов с учётом некоторой вариабельности. Необходима метрика близости строк, в качестве которой чаще всего выступает расстояние Левенштейна. Оно определяется как минимальное количество односимвольных операций (вставки, удаления, замены), необходимых для превращения одной последовательности символов в другую. Расстояние Левенштейна вычисляется методом динамического программирования. Пусть – расстояние между префиксами длины и строк и , тогда:
Базовые случаи очевидны: и , поскольку пустую строку можно получить только удалением всех символов. Заполнение таблицы занимает времени, а память, как и в задаче о рюкзаке, сжимается до одной строки, если сам путь преобразования восстанавливать не требуется. Если же нас интересует лишь факт, что расстояние не превышает заданного порога , достаточно заполнять диагональную полосу шириной , что даёт .
Расстояние Левенштейна не единственная метрика, и выбор зависит от природы данных:
- расстояние Дамерау-Левенштейна добавляет к операциям перестановку соседних символов, что ближе к реальным опечаткам при наборе;
- расстояние Хэмминга считает только замены и определено лишь для строк равной длины, зато вычисляется мгновенно;
- мера Джаро-Винклера даёт дополнительный вес совпадающему началу строк и традиционно применяется к именам и фамилиям;
- коэффициент Жаккара на множествах n-грамм не требует посимвольного сопоставления и потому хорош как быстрый предварительный фильтр для длинных строк.
Если требуется найти в большом наборе объекты, ближайшие к заданному, – это задача поиска ближайших соседей. Прямолинейное решение вычисляет расстояние до каждого объекта набора, то есть обходится в вычислений метрики на один запрос. При словаре в миллионы строк или базе эмбеддингов в миллиарды векторов это неприемлемо, поэтому строят индексные структуры. Основные подходы:
- метрические деревья (BK-дерево, VP-дерево) опираются на неравенство треугольника: зная расстояние от запроса до опорного объекта, можно отбросить целые поддеревья, не вычисляя расстояний до их содержимого;
- пространственные структуры (kD-дерево, R-дерево, равномерная сетка) разбивают само пространство признаков и подробно разбираются в главе 12;
- локально-чувствительное хеширование (Locality-Sensitive Hashing, LSH) использует семейство хеш-функций, которые с высокой вероятностью дают одинаковый хеш близким объектам. Кандидаты берутся из той же корзины, что и запрос, а расстояние считается только для них;
- графовые индексы (NSW, HNSW) строят граф соседства, по которому поиск идёт жадным спуском от случайной точки к запросу. Сегодня это фактический стандарт для поиска по эмбеддингам.
Здесь важно понимать общее ограничение, известное как проклятие размерности: с ростом числа измерений расстояния между всеми парами объектов становятся всё более похожими, и точные структуры разбиения пространства деградируют до полного перебора. Уже при нескольких десятках измерений kD-дерево перестаёт давать выигрыш. Поэтому для векторов высокой размерности переходят к приближённому поиску (Approximate Nearest Neighbors), который не гарантирует нахождение всех истинных соседей, зато работает на порядки быстрее. Качество такого поиска измеряют полнотой – долей настоящих соседей среди найденных, – и обменивают её на скорость настройкой параметров.
Наконец, о практических реализациях. Для нечёткого поиска по строкам метрические деревья почти вытеснены: поисковое ядро Lucene строит по образцу автомат Левенштейна и пересекает его со словарём термов, PostgreSQL использует триграммные индексы (расширение pg_trgm), а для исправления опечаток хорошо себя показывает схема симметричного удаления (SymSpell), которая заранее строит варианты слов с удалёнными символами и сводит поиск к обращению к хеш-таблице. Для поиска по векторам применяют библиотеку FAISS и реализации HNSW в pgvector, Qdrant и Elasticsearch.
10.6. Полнотекстовый поиск
Для организации поиска по каталогу текстовых документов обычного поиска подстроки недостаточно. Необходимо искать вхождения ключевых слов вне зависимости от их формы, а также ранжировать результаты по релевантности. Это и есть полнотекстовый поиск, с которым вы могли сталкиваться на различных сайтах и в приложениях.
На первом этапе тексты подвергаются препроцессингу: нормализации, токенизации, удалению стоп-слов, приведению к базовым формам (лемматизация или стемминг). В результате каждый документ представляется последовательностью термов (базовых форм слов).
Затем строится так называемый обратный индекс, где для каждого терма составляется список ID всех документов, где он встречался (рисунок 34). Такой список называют постинг-листом. По сути обратный индекс – это тот же мешок слов, только хранимый транспонированным: не «документ – вектор частот термов», а «терм – документы, где он встречается». Документы в нём расположены упорядоченно, а также может храниться различная мета-информация вроде количества и позиции вхождений. Это используется при подсчёте метрик релевантности или для выполнения специфичных запросов, в которых важно взаимное расположение термов в документе.
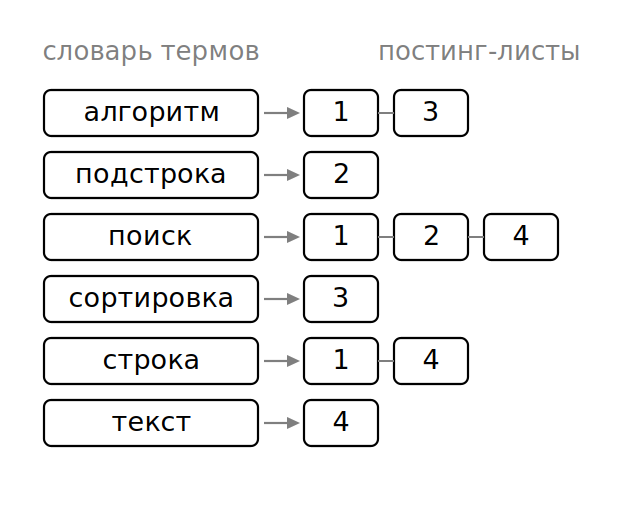
На хеш-таблице или префиксном дереве (что даст автодополнение) строится словарь термов, в котором для каждого терма хранится адрес его постинг-листа в RAM или долговременной памяти.
Документы, обнаруживаемые в постинг-листе необходимого терма, ранжируются метриками релевантности. Наиболее популярные из них – TF-IDF и BM25.
Релевантность документа запросу складывается из вкладов отдельных термов запроса:
Вес терма в документе по TF-IDF равен произведению двух множителей:
Здесь – количество вхождений терма в документ , – количество документов корпуса, содержащих этот терм, а – общее количество документов. Первый множитель поднимает документы, в которых терм встречается часто, второй гасит вклад термов, встречающихся повсюду: если терм есть почти в каждом документе, он ничего не различает.
BM25 развивает ту же идею, устраняя два недостатка предыдущей формулы:
Во-первых, вклад повторов насыщается. В (37) сотое вхождение терма добавляет ровно столько же, сколько второе, тогда как дробь в (38) с ростом стремится к , а коэффициент (обычно от 1.2 до 2.0) задаёт скорость насыщения. Во-вторых, учитывается длина документа относительно средней по корпусу : без такой поправки длинные документы выигрывали бы просто за счёт объёма. Силу поправки задаёт коэффициент (обычно 0.75), при она отключается. Множитель устроен так же, как второй множитель в (37), но со сглаживанием, чтобы вес не обращался в нуль для термов, встречающихся во всех документах.
Для вывода топа самых релевантных результатов применяется алгоритм Heapselect на бинарной куче минимумов, упорядоченной по релевантности: при обходе постинг-листа от начала и до конца первые документов кладутся в кучу безусловно. А затем каждый последующий документ сначала оценивается и кладётся в кучу, только если его выше минимального из кучи. Минимум в такой куче лежит в корне, поэтому проверка обходится в , а вытеснение худшего документа – в .
Постинг-листы упорядочены по ID документов, и именно это делает обработку запросов дешёвой: списки не нужно вычитывать целиком и сортировать. Для каждого терма запроса заводится итератор по его постинг-листу, после чего все итераторы двигаются вперёд согласованно, как при слиянии упорядоченных последовательностей. Различаются виды запросов лишь тем, какие документы при этом принимаются.
Запрос OR считает подходящим документ, содержащий хотя бы один из термов, то есть принимает каждый встреченный. На очередном шаге выбирается наименьший из ID, на которые указывают итераторы. Все указывающие на него итераторы дают набор термов запроса, встретившихся в этом документе, по нему считается релевантность (36), и документ отправляется в top-K кучу по правилу Heapselect. После этого сработавшие итераторы продвигаются на один элемент. Чтобы не пересортировывать весь набор итераторов на каждом шаге, их держат в куче минимумов по текущему ID: извлечение минимума и возврат продвинутого итератора обходятся в , где – количество термов в запросе.
Запрос AND требует присутствия всех термов сразу, а потому принимает только документы, на которые указывают одновременно все итераторы. Это пересечение постинг-листов, и здесь появляется дополнительная возможность: отстающие итераторы можно двигать не по одному элементу, а сразу к наибольшему из текущих ID, пропуская заведомо непригодные участки. Для таких перемещений в постинг-листах заводят списки с пропусками (skip lists) – дополнительные ссылки через несколько элементов вперёд, позволяющие прыгать, а не перебирать. Выигрыш тем больше, чем сильнее различаются длины списков: редкий терм задаёт небольшое число кандидатов, а длинный список частого терма проматывается прыжками.
Полнотекстовый поиск реализован во многих СУБД и поисковых движках: в PostgreSQL, расширении FTS5 для SQLite, в поисковом ядре Lucene и построенных на нём Elasticsearch и OpenSearch и т.д. Сегодня к обычному полнотекстовому поиску также добавляют поиск по эмбеддингам с приближённым поиском ближайших соседей, а стандартом стала гибридная схема, объединяющая оба списка результатов.