8. Решение задач поиском в графе состояний
8.1. Общая концепция
Разбирая тему алгоритмов поиска пути в графе, мы решали прямолинейную задачу. Граф являлся формальным представлением карты, игрового уровня или другого пространства, в котором может происходить перемещение объекта или персонажа. В данной главе мы снова возвращаемся к уже изученным алгоритмам, но с целью значительно расширить сферу их применимости.
Сперва введём ключевое понятие – пространство состояний (поисковое пространство, граф состояний). Пусть некий объект или система описывается набором характеристик/переменных. Выбор характеристик диктуется решаемой задачей. Конкретные значения переменных задают одно возможное состояние объекта. Пусть также имеется набор действий, которые может совершать объект или которые могут совершаться над ним. Применение действия переводит объект из одного состояния в другое (меняет значения переменных). Тогда можно ввести модель ориентированного графа, в котором узлы – возможные состояния, а рёбра – переходы между ними в результате совершения конкретных действий. Подобный граф, представляющий все возможные состояния/комбинации, и называют пространством состояний.
Проиллюстрируем примером. Пусть имеется комната, дискретизированная квадратной сеткой. Каждая клетка может быть чистой или содержать мусор. В этой комнате находится робот-пылесос, который на каждом своём шаге может совершить одно из действий: переместиться в одну из смежных клеток или засосать мусор под собой (с клетки, на которой находится). Возьмём для простоты вырожденный случай, когда клеток всего две, тогда полный набор действий: L (переместиться влево), R (переместиться вправо), S (засосать мусор). Для кодирования состояния такой системы достаточно 3 булевых переменных (две для состояний клеток и одна для положения пылесоса). Всего возможных состояний системы – 2x2x2 = 8. Такой граф состояний можно нарисовать целиком (рисунок 24).
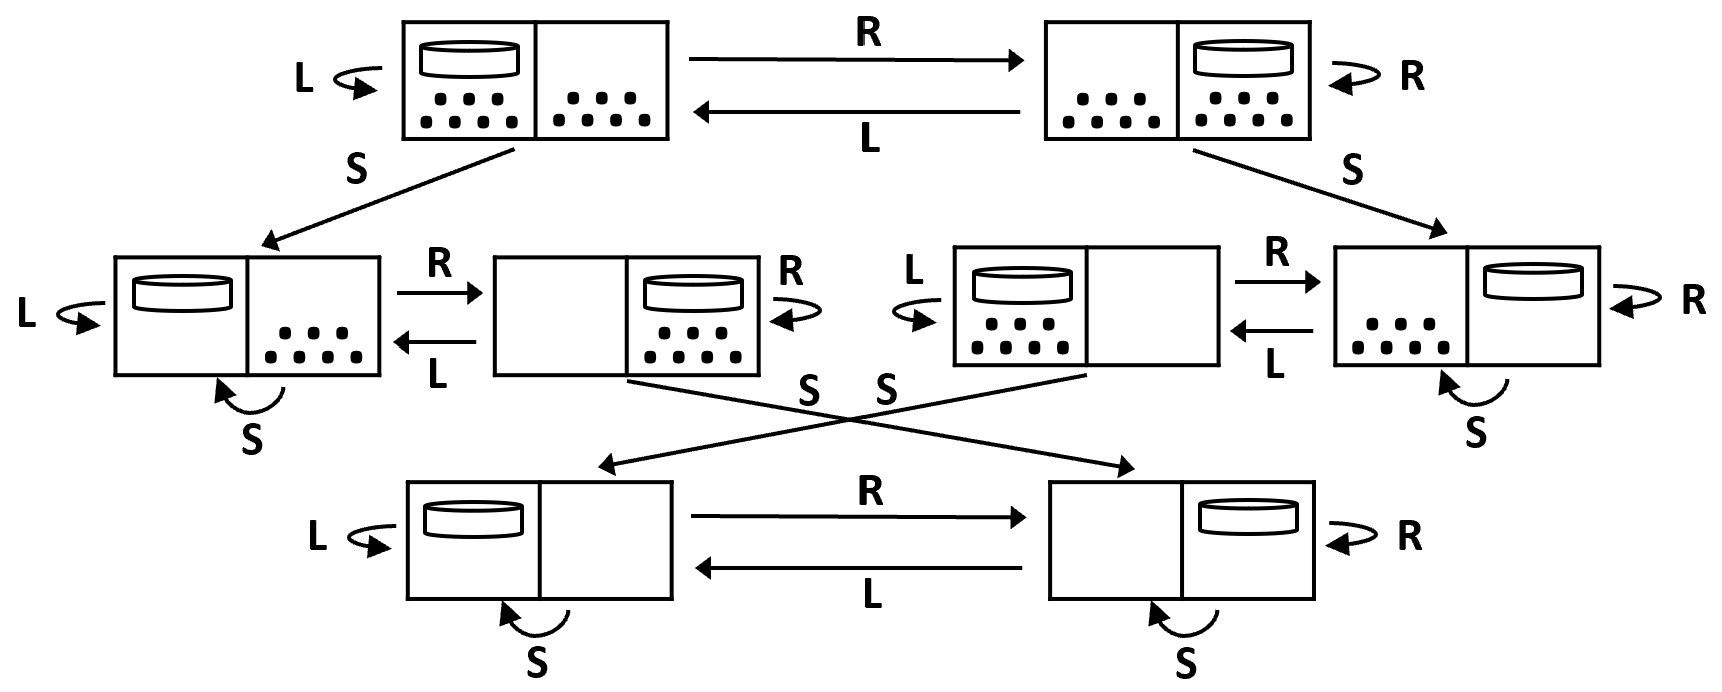
В случае усложнения задачи (увеличения размеров сетки, увеличения количества дискретных состояний клетки) размер графа будет экспоненциально увеличиваться. Кроме того, в невырожденном случае действий-перемещений будет 4 (если допустимы шаги только по вертикали или горизонтали) или больше. В результате кратно вырастет степень узлов, т.е. число смежных каждому из них.
Пусть нас интересует достижение для рассматриваемого объекта некого целевого состояния, которое может быть задано явно или косвенно (через условия, которым оно должно удовлетворять). Для примера с пылесосом это состояние чистоты комнаты. Пусть нам также известно начальное состояние рассматриваемого объекта. Тогда задача достижения целевого состояния превращается в задачу обхода графа, начиная с начального узла, и до посещения целевого. К примерам таких задач можно отнести Судоку или задачу о восьми ферзях: как расставить 8 ферзей на шахматной доске так, чтобы они не били друг друга. Подобные задачи называют задачами удовлетворения ограничений (Constraint Satisfaction Problem). Если же нас интересует последовательность действий, приводящая в целевое состояние (план), то получаем задачу планирования. Она повсеместна в робототехнике, ИИ, играх, для решения головоломок вроде пятнашек, кубика Рубика, Ханойских башен и т.д. У каждого совершаемого действия может быть задана его цена, а задача усложнится до поиска оптимального плана. Если стоимости действий одинаковы, то оптимален план с наименьшим количеством шагов. Иначе – план с минимальной суммарной стоимостью требуемых действий.
Итак, прямолинейная задача поиска пути в пространстве – частный случай более широкого класса задач. В ней заданы все необходимые компоненты:
- модель состояния объекта (его координаты);
- начальное состояние (начальные координаты);
- целевое состояние (конечные координаты);
- возможные действия (перемещения в смежные узлы графа или клетки сетки), для которых могут быть указаны стоимости (взвешенная задача).
Но поиск в координатном пространстве сильно отличается в подходах от общего случая. В частности, ранее мы исходили из того, что граф является входными данными, т.е. целиком представлен в памяти. Это оправданное допущение, если мы говорим о формальном представлении карты или игрового уровня. Однако количество возможных дискретных состояний объекта в общем случае может быть столь велико, что не будет помещаться в оперативную память. Теоретически оно может быть даже бесконечно. Поэтому в сфере ИИ выработались свои подходы как к решению, так и анализу сложности (ведь в классическом применении сложность алгоритма поиска определялась размерами графа).
Первое ключевое отличие – узлы графа (состояния) разворачиваются на лету путём применения к рассматриваемому узлу всех возможных для соответствующего состояния действий. Это даёт смежные узлы. Таким образом, граф состояний не нужно целиком хранить в памяти. В процессе работы алгоритма строится лишь дерево обхода, которое является частью графа. А сам граф остаётся умозрительной моделью, а не структурой в памяти.
Второе ключевое отличие – подход к анализу сложности. Алгоритмы поиска в графе перебирают узлы-кандидаты в цикле. Значит, количество итераций и время работы алгоритма пропорциональны количеству узлов, которые будут рассмотрены алгоритмом до момента завершения. Здесь и далее при указании сложностей алгоритмов поиска будут использоваться следующие обозначения:
- – коэффициент ветвления (среднее количество действий, которые могут быть применены к произвольному состоянию);
- – глубина самого поверхностного целевого узла;
- – максимальная длина пути в пространстве состояний.
Третье ключевое отличие – неприменимость тех же эвристик в случае использования алгоритмов вроде A*. Манхэттенское расстояние или расстояние Евклида – оценки расстояний между двумя точками в пространстве. Для произвольной задачи планирования нужна другая эвристика, которая оценивала бы минимальную стоимость плана по достижению цели. О методах формулирования подобных эвристик будет сказано далее в этой главе.
8.2. Стратегии поиска
Абстрактный алгоритм поиска может быть сформулирован следующим образом:
def expand(node):
    # Развёртывание узла: применение к его состоянию всех допустимых действий
    children = []
    for each action, применимое к node.state:
        children.append(SearchNode(
            state = результат применения action к node.state,
            parent = node,
            action = action,
            depth = node.depth + 1,
            cost = node.cost + (стоимость действия action)))
    return children

def build_plan(node):
    # Восстановление плана: от целевого узла вверх по ссылкам на родителей
    plan = []
    while node.parent != None:
        plan.append(node.action)
        node = node.parent
    return plan в обратном порядке

def search(start, is_goal):
    start_node = SearchNode(state=start, parent=None, action=None, depth=0, cost=0)
    # Открытый список - кандидаты на развёртывание. В зависимости от
    # стратегии это стек, очередь или очередь с приоритетом
    candidates = init_candidates()
    candidates.push(start_node)
    # Закрытый список - состояния, которые уже были развёрнуты
    closed = init_set()
    while candidates не пуста:
        node = candidates.pop()
        if node.state in closed:
            continue # состояние уже развёрнуто по не худшему пути
        if is_goal(node.state):
            return build_plan(node)
        closed.add(node.state)
        for child in expand(node):
            if child.state not in closed:
                # Для очереди с приоритетом ключ задаётся стратегией:
                # child.cost, child.cost + h(child.state) и т.д.
                candidates.push(child)
    return None # решение не существует
В зависимости от используемой структуры для хранения узлов-кандидатов на развёртывание могут быть получены различные алгоритмы поиска, о которых мы уже вели речь: стек – поиск в глубину, очередь – поиск в ширину, очередь с приоритетом – A* или жадный поиск по первому наилучшему совпадению.
Каждый узел дерева обхода должен содержать как минимум следующие поля:
state– закодированное состояние;parent– ссылка на родительский узел (из какого состояния перешли в данное);action– действие, в результате применения которого перешли в данное состояние;depth– глубина (количество шагов от начального узла);cost– стоимость пути от начального узла до текущего ().
Для сравнения различных стратегий поиска нам важна не только временная и пространственная сложность, но и два фундаментальных свойства:
- полнота – гарантирует ли алгоритм обнаружение решения, если оно имеется;
- оптимальность – обеспечивает ли данная стратегия нахождение оптимального решения (с наименьшей стоимостью пути).
Все стратегии поиска делят на информированные и неинформированные. Стратегии информированного поиска используют информацию о предметной области. В частности, к таковым относятся эвристические алгоритмы вроде A*. В таблице 5 приведены свойства основных стратегий неинформированного поиска.
Таблица 5. Свойства стратегий неинформированного поиска
| В ширину | По критерию стоимости | В глубину | С ограничением глубины | С итеративным углублением | Двунаправленный в ширину | |
|---|---|---|---|---|---|---|
| Полнота | Если конечен | Если конечен и стоимости действий , | Нет | Нет | Если конечен | Если конечен |
| Оптимальность | Если стоимости действий равны | Да | Нет | Нет | Если стоимости действий равны | Если стоимости действий равны |
| Временная сложность | ||||||
| Пространственная сложность |
Принципы базовых алгоритмов поиска в глубину (DFS) и ширину (BFS) уже были нами рассмотрены ранее. Оба эти варианта не особенно применимы для сложных задач. Поиск в ширину оптимален, если стоимость пути – неубывающая функция глубины узла, а также полон, если конечен. Но он развернёт экспоненциальное число узлов, причём все они должны будут храниться в памяти. К примеру, при 1000 байтах на узел, скорости обработки в 10 000 узлов в секунду, коэффициенте ветвления 10 и глубине решения 8 вычисления займут 31 час и потребуют 1 терабайт памяти. А при глубине 10 решение уже займёт 129 суток и потребует 101 терабайт. Поиск в глубину тоже слабо применим: он и неполный, и неоптимальный. Максимальная длина пути может быть гораздо больше (и даже может быть бесконечной, если глубину не ограничить). Однако есть и плюс – линейные затраты памяти (единовременно в памяти хранится не всё дерево обхода, а только текущий путь и нераскрытые смежные узлы для каждого на этом пути).
Поиск с ограничением глубины – это примитивная модификация поиска в глубину, при которой предельная глубина обхода ограничивается заранее заданной . Так решается проблема бесконечного пути, но возникает другая – риск установки , когда решение заведомо не сможет быть найдено.
Поиск по критерию стоимости (Uniform Cost Search) – такой вариант алгоритма, где в качестве приоритета кандидатов (в очереди с приоритетом) рассматривается стоимость cost. Т.е. это аналог алгоритма Дейкстры. Полнота такого поиска требует, чтобы стоимость каждого действия была не меньше некоторой положительной величины . Иначе бесконечный путь может иметь конечную суммарную стоимость – например, если стоимости действий убывают как Тогда алгоритм бесконечно долго будет разворачивать всё более дешёвые узлы, так и не добравшись до цели. Пусть – стоимость оптимального решения. Тогда временная и пространственная сложности в худшем случае – .
Поиск с итеративным углублением (Iterative Deepening DFS) объединяет сильные стороны примитивных алгоритмов: полноту и оптимальность BFS с линейными затратами памяти DFS. Реализация алгоритма выглядит следующим образом:
CUTOFF = специальное значение, означающее отсечение ветки по глубине

def iddfs(start, is_goal):
    start_node = SearchNode(state=start, parent=None, action=None, depth=0, cost=0)
    limit = 0
    while True:
        # Каждая итерация - независимый поиск в глубину с ограничением
        result = depth_limited(start_node, is_goal, limit)
        if result != CUTOFF:
            # Найдено решение либо доказано, что его не существует
            return result
        limit++

def depth_limited(node, is_goal, limit):
    if is_goal(node.state):
        return build_plan(node)
    if node.depth == limit:
        return CUTOFF # достигнут предел глубины, ветка не исчерпана
    cutoff = False # была ли отсечена хотя бы одна ветка поддерева
    for child in expand(node):
        if child.state встречается на пути от корня до node:
            continue # закрытого списка нет, отсекаем только простые циклы
        result = depth_limited(child, is_goal, limit)
        if result == CUTOFF:
            cutoff = True
        elif result != None:
            return result
    # Если ветки отсекались, решение может обнаружиться на большей глубине
    return CUTOFF if cutoff else None
На каждой итерации внешнего цикла заново запускается поиск с ограничением глубины, причём лимит глубины каждый раз увеличивается на 1. Т.к. никакие данные не накапливаются между итерациями, единовременные затраты совпадают с затратами базового алгоритма. При этом в дереве обхода каждой последующей итерации по сравнению с предыдущей добавляются только узлы нового самого глубокого уровня. Т.е. принцип рассмотрения по уровням аналогичен BFS, а значит, алгоритму присущи те же условия полноты и оптимальности. Может показаться, что всё это перекрывается недостатком – избыточностью. Ведь одни и те же узлы разворачиваются по многу раз. Однако количество узлов на более глубоких уровнях растёт экспоненциально, т.е. подавляющее большинство узлов всегда будет на новом уровне. Число узлов на уровне (при нумерации с 0) – , а суммарное число узлов во всех уровнях выше – . Число узлов на последнем уровне больше в раз. Значит, издержками на повторный обход всех уровней выше можно пренебречь (особенно при большом ).
Среди стратегий неинформированного поиска IDDFS предпочтителен, когда пространство поиска велико, а глубина решения неизвестна.
Двунаправленный поиск в ширину – вариант, при котором поиск осуществляется одновременно в двух направлениях: от начального состояния к целевому и от целевого к начальному. На каждой итерации алгоритма делается один шаг каждого поиска (прямого и обратного). Процедура продолжается до момента столкновения деревьев обхода в каком-то узле. Прямой поиск находит одну половину пути (от начального узла до узла столкновения), а обратный – вторую (от столкновения к целевому). Реализация такого подхода в общем виде выглядит так:
def bidirectional_bfs(start, goal):
    if start == goal:
        return []
    # Деревья обхода в виде словарей "состояние -> (смежное состояние, действие)".
    # В прямом дереве это родитель и приведшее в состояние действие,
    # в обратном - потомок и действие, ведущее из состояния к нему
    forward = { start: (None, None) }
    backward = { goal: (None, None) }
    forward_queue = init_queue(); forward_queue.push(start)
    backward_queue = init_queue(); backward_queue.push(goal)

    while forward_queue не пуста и backward_queue не пуста:
        # Шаг прямого поиска - развёртывание применимыми действиями
        meeting = step(forward_queue, forward, backward, вперёд)
        if meeting != None:
            return build_plan_bidirectional(meeting, forward, backward)
        # Шаг обратного поиска - развёртывание обратными действиями
        meeting = step(backward_queue, backward, forward, назад)
        if meeting != None:
            return build_plan_bidirectional(meeting, forward, backward)
    return None

def step(queue, own_tree, other_tree, direction):
    state = queue.pop()
    # При direction = вперёд пара - это следующее состояние и ведущее в него
    # действие, при direction = назад - предыдущее состояние и действие,
    # ведущее из него в state
    for each пара (other_state, action) для state в направлении direction:
        if other_state in own_tree:
            continue
        own_tree[other_state] = (state, action)
        if other_state in other_tree:
            return other_state # деревья обхода столкнулись
        queue.push(other_state)
    return None

def build_plan_bidirectional(meeting, forward, backward):
    plan = []
    # Первая половина плана - от места столкновения к начальному состоянию
    state = meeting
    while forward[state] != (None, None):
        parent, action = forward[state]
        plan.append(action)
        state = parent
    развернуть plan в обратном порядке
    # Вторая половина - от места столкновения к целевому состоянию
    state = meeting
    while backward[state] != (None, None):
        next_state, action = backward[state]
        plan.append(action)
        state = next_state
    return plan
Для быстрой проверки столкновения потребуется эффективная реализация множества (например, на базе хеш-таблицы). Подход применим только для тех задач, где целевой узел (или небольшое конечное число целевых узлов) задан в явном виде, а действия обратимы, т.е. по результирующему состоянию и применённому действию можно однозначно восстановить предыдущее состояние. Преимущество такого метода по сравнению с обычным поиском в ширину – в числе разворачиваемых узлов (а значит, во временной и пространственной сложности). Если целевой узел находится на глубине от начального, то дерево обхода обычного поиска будет содержать узлов. А два дерева глубины содержат узлов, что ощутимо меньше.
Стратегии информированного поиска, как правило, значительно более эффективны. Среди них мы уже знакомы с базовыми алгоритмами A* и GBFS (поиск по первому наилучшему совпадению). Однако даже они могут не справляться с крупными задачами. Поэтому можно также выделить некоторые их модификации:
- ограничение затрат памяти – Iterative Deepening A* (IDA*), Simplified Memory-bounded A*, Recursive Best-First Search (RBFS);
- ослабление оптимальности – Weighted A*, Anytime Repairing A*;
- учёт динамики – Lifelong Planning A*, D* Lite.
IDA* объединяет идеи A* и IDDFS. В отличие от IDDFS здесь итеративно растёт не глубина, а лимит на оценку стоимости пути . Сперва он устанавливается в значение эвристической оценки для стартового узла. Затем на каждой итерации запускается обычный DFS, но как только узла превысит порог, ветка отсекается. Если цель не найдена, то новый порог выставляется в минимальное из отсечённых . Порог поднимается ровно до следующего реально существующего значения . Поэтому первая же найденная цель оптимальна – при допустимой (недооценивающей) эвристике. Реализация выглядит следующим образом:
def ida_star(start, is_goal, heuristic):
    start_node = SearchNode(state=start, parent=None, action=None, depth=0, cost=0)
    threshold = heuristic(start) # начальный порог - оценка f стартового узла
    while True:
        # Поиск возвращает либо решение, либо минимальное из отсечённых f
        result, next_threshold = bounded_dfs(start_node, is_goal, heuristic, threshold)
        if result != None:
            return result
        if next_threshold == ∞:
            return None # отсекать больше нечего, решения не существует
        # Порог поднимается ровно до следующего реально существующего f
        threshold = next_threshold

def bounded_dfs(node, is_goal, heuristic, threshold):
    f = node.cost + heuristic(node.state)
    if f > threshold:
        return None, f # ветка отсечена, возвращаем её оценку
    if is_goal(node.state):
        return build_plan(node), threshold
    minimum = ∞ # минимальное f среди отсечённых веток поддерева
    for child in expand(node):
        if child.state встречается на пути от корня до node:
            continue # закрытого списка нет, отсекаем только простые циклы
        result, cutoff_f = bounded_dfs(child, is_goal, heuristic, threshold)
        if result != None:
            return result, threshold
        if cutoff_f < minimum:
            minimum = cutoff_f
    return None, minimum
Обычный A* хранит узлов в открытом и закрытом списках. IDA* хранит только стек рекурсии – . Как и в IDDFS, одни и те же состояния разворачиваются многократно. Но если ветвление большое, последняя итерация доминирует, и суммарные накладные расходы – константный множитель . Алгоритм применим только при относительно малом числе различных значений . Если же почти каждый узел даёт своё уникальное вещественное значение , то за итерацию будет добавляться лишь один новый узел. Второе условие связано с отсутствием закрытого списка: пространство поиска должно быть близко по форме к дереву. Если же существует множество способов попасть в одни и те же состояния, то получим экспоненциальный взрыв. Типичная область применения – головоломки вроде пятнашек и кубика Рубика.
Концепция взвешенного A* (Weighted A*) заключается в ослаблении строгой гарантии оптимальности, что даёт многократный выигрыш в производительности. Оценка стоимости пути принимает вид . Стоимость найденного решения превысит оптимальную не более чем в раз. На практике при решения обычно оказываются в пределах нескольких процентов от оптимума, тогда как число раскрытых узлов падает на порядки.
Ключевое для всех алгоритмов информированного поиска – эвристика . Её качество напрямую определяет эффективность и оптимальность алгоритма. Поэтому вопрос принципов разработки эвристических оценок – важнейший для решения сложных задач.
8.3. Методы получения эвристических оценок
Для одной и той же задачи может быть множество способов оценить нижнюю границу стоимости. И получение более эффективных эвристик для различных фундаментальных задач является непрекращающимся процессом и областью интереса научных исследований.
Существуют различные способы получения эвристик. Наиболее общим и широко распространённым является приём релаксации. Ослабленной или релаксированной называется задача, из которой убрали часть изначальных ограничений. Оптимальный план решения полученного более простого экземпляра будет гарантированно не длиннее плана решения оригинала, а значит, является нижней границей. Кроме того, будет автоматически соблюдаться и неравенство треугольника.
Релаксация может затрагивать разные ограничения. Продемонстрируем на примере игры в восемь (вариант пятнашек с размером поля 3x3). Правила перемещения блоков заданы следующим образом: блок может быть сдвинут из квадрата A в квадрат B, если квадрат A является смежным по горизонтали или по вертикали с квадратом B и квадрат B пуст. Отбрасыванием разных ограничений получим такие варианты релаксации:
- блок может быть передвинут из квадрата A в квадрат B, если квадрат A является смежным с квадратом B;
- блок может быть передвинут из квадрата A в квадрат B, если квадрат B пуст;
- блок может быть передвинут из квадрата A в квадрат B.
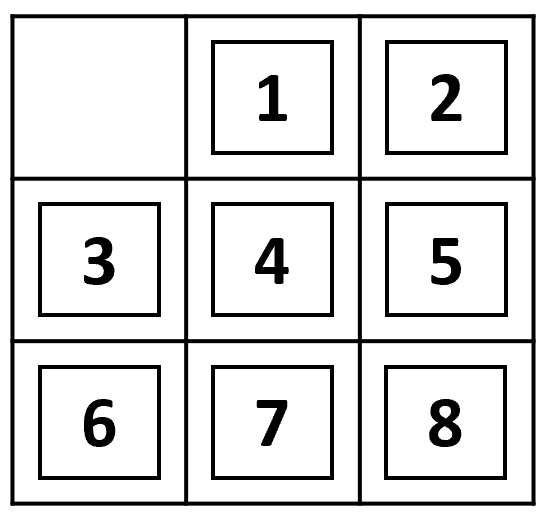
Вариант 3 предполагает, что блоки могут за 1 шаг «телепортироваться» на нужную позицию, и они не мешают друг другу. Тогда количество шагов равно числу блоков, не стоящих на своём месте. Обозначим это как эвристику . Вариант 1 предполагает, что блоки не мешают друг другу, но за раз их можно двигать только на одну позицию. Тогда общее число сдвигов равно сумме манхэттенских расстояний всех блоков от их целевых позиций. Обозначим такую эвристику как . Из формулировки 2 тоже можно получить вариант эвристики, но его мы опустим.
И , и – допустимые эвристики в том смысле, что являются нижними границами. Однако при попытке экспериментального сравнения мы бы обнаружили, что для одних и тех же узлов сохраняется соотношение , а A* стабильно перебирает меньшее количество узлов при использовании . Это значит, что доминирует над , является более точной оценкой. Это логично, т.к. получена путём отбрасывания сразу двух ограничений, а – только одного из них. Чем сильнее мы упростим исходную задачу, тем менее точную оценку получим. Однако вычисление более точной оценки обычно затратнее по времени, и это может нивелировать повышение эффективности комбинаторного поиска. Позднее, обсуждая метод ветвей и границ, мы укажем, как можно сочетать эвристики разной точности для их динамической подмены. Стоит также сказать, что эвристика, получаемая из варианта релаксации 2, тоже будет заведомо точнее . Однако результат сравнения с может варьироваться на разных входных состояниях, т.к. эвристики получены путём отбрасывания совсем разных ограничений.
Второй способ получения оценки нижней границы – решение подзадачи. Например, для игры в восемь подзадачей может быть расстановка не всех 8 блоков на нужные позиции, а их подмножества (например, блоков с 1-го по 4-й). Подзадача заведомо проще целого оригинала, поэтому её решение будет являться нижней границей. Этот способ хорошо сочетается с другим приёмом: базами данных шаблонов (pattern databases). Число вариантов расположения 4 блоков и пустой клетки на поле 3x3 равно , что во много раз меньше количества состояний в исходной системе. А значит, мы можем вычислить заранее и хранить точные значения для каждого варианта подзадачи.
Третьим и очень популярным способом является применение машинного обучения. Для этого необходимо заготовить датасет: набор различных состояний с указанной стоимостью решения. Построение модели регрессии позволит предсказывать стоимость для произвольных состояний. Модель, обученная на обширных и качественных данных, будет выдавать довольно точные оценки, причём быстро и вычислительно эффективно. Стоит, однако, отметить, что при таком подходе теряется гарантия того, что эвристика не будет переоценивать. А значит, и планы, которые будет строить алгоритм, не будут гарантированно оптимальными.
Могут быть и другие подходы. Все они позволяют получить различные эвристики, и не всегда какая-то одна из них будет доминировать. На одних входных данных точнее может оказаться одна, на других – другая. Если нам критично получить эвристику максимальной точности и мы готовы мириться с ростом времени её вычисления, то агрегированная эвристика, берущая лучшее от нескольких, формулируется как:
Т.к. эвристики независимы, то их вычисление может производиться параллельно, благодаря чему можно существенно понизить временные затраты.
8.4. Поиск с возвратом
Как упоминалось ранее, в задачах удовлетворения ограничений (CSP) путь к цели неважен, важна сама структура целевого состояния. Формально экземпляр CSP задаётся тройкой: множеством переменных, множеством допустимых значений (доменом) для каждой из них и множеством ограничений, связывающих значения переменных. Решением является присваивание значений всем переменным, при котором ни одно ограничение не нарушено. К такому виду сводятся судоку (переменные – пустые клетки, домены – цифры от 1 до 9, ограничения – различность значений в строке, столбце и квадрате), раскраска карты, составление расписаний, задача о восьми ферзях.
Прямолинейный подход к CSP – метод грубой силы: сгенерировать все комбинации значений и проверить каждую на соответствие ограничениям. Для восьми ферзей на доске 8x8 это млрд расстановок. Однако ограничения известны заранее, а значит, проверять их можно не в конце, а по мере построения комбинации. На этом и основан метод поиска с возвратом (backtracking).
Идея метода состоит в том, что комбинация строится по одной переменной за шаг, а состоянием является частичное присваивание. Тогда пространство состояний – дерево, корень которого пустое присваивание, а листья на глубине (при переменных) – полные комбинации. Как только очередное частичное присваивание нарушает какое-либо ограничение, вся ветка отсекается целиком: любое её продолжение заведомо не является решением. Алгоритм возвращается на шаг назад (отсюда и название) и пробует следующее значение. Т.е. поиск с возвратом – это поиск в глубину по дереву частичных решений с отсечением заведомо непригодных ветвей:
def backtrack(assignment, variables):
    if len(assignment) == len(variables):
        return assignment # все переменные назначены, решение найдено
    var = variables[len(assignment)] # очередная неназначенная переменная
    for each value из домена переменной var:
        if присваивание var = value не нарушает ограничений с назначенными:
            assignment[var] = value
            result = backtrack(assignment, variables)
            if result != None:
                return result
            # Ни одно продолжение не привело к решению - возврат
            удалить var из assignment
    return None # на этой ветке решения нет
Та же схема применима шире, чем к CSP: по ней порождаются перестановки, подмножества, разбиения и прочие комбинаторные объекты. В этом случае проверка ограничений вырождается в проверку допустимости очередного добавляемого элемента, а искомым результатом может быть не одна комбинация, а все сразу – тогда перебор просто не прерывается при нахождении очередной.
Проиллюстрируем задачей о восьми ферзях. Т.к. в каждом столбце обязан стоять ровно один ферзь, для кодирования состояния достаточно 8 переменных – по одной на столбец, а значением каждой будет номер строки. Это сокращает пространство с упомянутых 4.4 млрд до млн вариантов, причём ограничение «не бить по вертикали» оказывается учтено самой моделью. Остаётся проверять горизонтали и диагонали:
def is_valid(rows, column, row):
    # rows[i] - строка ферзя в i-м столбце (столбцы заполняются слева направо)
    for i = 0; i < column; i++:
        if rows[i] == row:
            return False # общая горизонталь
        if abs(rows[i] - row) == column - i:
            return False # общая диагональ
    return True
С такой моделью и отсечением непригодных веток первое решение находится после развёртывания всего 113 узлов, а полный перебор всех 92 решений требует 2056 узлов. Затраты по памяти – : хранится только текущее частичное присваивание. Это ниже общей оценки для поиска в глубину из таблицы 5, поскольку значения из домена перебираются по одному, без одновременного развёртывания всех потомков. Полнота при этом обеспечена конечностью глубины дерева, которая равна числу переменных.
Эффективность метода почти целиком определяется тем, насколько рано отсекаются непригодные ветви. Отсюда и основные направления его улучшения, составляющие отдельную обширную тему:
- эвристики порядка перебора – первой назначать переменную с наименьшим числом допустимых значений (minimum remaining values, MRV), а значение выбирать то, которое оставляет больше вариантов остальным переменным (least constraining value, LCV);
- распространение ограничений (constraint propagation) – после каждого присваивания сокращать домены связанных переменных и возвращаться сразу, как только чей-либо домен опустел; простейший вариант такой проверки называют forward checking;
- учёт симметрий – у задачи о восьми ферзях 92 решения, но с точностью до поворотов и отражений доски различны лишь 12 из них, поэтому симметричные ветви можно не рассматривать вовсе.