9. Дискретная оптимизация
9.1. Постановка задачи
Мы уже решали задачи, в которых требовалось не просто найти решение, удовлетворяющее заданным условиям, а выбрать наилучшее из множества возможных: задачу о размене, о рюкзаке, о назначениях, поиск кратчайшего пути и оптимального плана. Все они относятся к оптимизационным. Математическая модель любой такой задачи складывается из трёх компонентов:
- Управляемые переменные, значения которых мы вольны выбирать. Вместе они образуют вектор решения:
- Ограничения, которым обязано удовлетворять решение (могут и отсутствовать). Совокупность равенств и неравенств, которые выделяют из область допустимых решений:
- Целевая функция (критерий оптимальности), сопоставляющая каждому допустимому решению числовую оценку его качества:
Минимальное/максимальное значение называют оптимумом или экстремумом; решение , при котором оно достигается, – оптимальным решением. Минимум и максимум достигаются на одном и том же решении, поэтому задача максимизации легко превращается в задачу минимизации и наоборот.
Фундаментальные классы оптимизационных задач определяются природой множества . В частности, если , то задачу называют задачей непрерывной оптимизации. Её решение ищется с помощью аппарата математического анализа: производные, градиент и т.д. Если же множество допустимых значений каждой переменной конечно или счётно (например, ), задача называется задачей дискретной оптимизации.
Пример задачи дискретной оптимизации – задача о рюкзаке. Запишем теперь её математическую модель формально:
В этой и многих других задачах мы ищем некую оптимальную комбинацию, что позволяет говорить о комбинаторной оптимизации. Однако, как видно, комбинации кодируются с помощью дискретных (в данном случае булевых) переменных. Поэтому комбинаторная и дискретная оптимизации – фактически одно и то же.
Стоит также сказать, что оптимизация – это не только и не столько концептуальный класс задач, сколько подход к поиску решения. Очень многие проблемы могут быть переформулированы как оптимизация некой целевой функции или функций:
- хотим спроектировать оптимальный по каким-то критериям объект (проектирование);
- хотим добиться конкретных показателей системы – минимизация отклонения от целевых показателей;
- текущее состояние системы не устраивает (не удовлетворяет ограничениям) – минимизация вносимых изменений так, чтобы стала удовлетворять;
- обучаем модели регрессии, прогнозирования, классификации – минимизация ошибки, что и есть суть машинного обучения.
В дискретных задачах область обычно конечна, а значит, оптимум заведомо существует и достижим. Однако мощность растёт с размером входа катастрофически быстро, из-за чего полный перебор невозможен и необходимы изощрённые приёмы и приближённые методы. Яснее трудности решения подобных задач становятся из теории классов сложности.
9.2. Классы сложности задач
Ранее мы говорили о сложности алгоритмов. Теперь речь пойдёт о сложности самих задач, т.е. о том, на что в принципе можно рассчитывать при поиске алгоритма для конкретной задачи.
Классы сложности определяют для задач распознавания – тех, ответом на которые служит «да» или «нет». Любую оптимизационную задачу легко переформулировать в распознавательную, добавив порог: вместо «найти рюкзак наибольшей ценности» спрашиваем «существует ли набор предметов ценностью не менее , помещающийся в рюкзак». Обе постановки равносильны по трудности: имея быстрый ответ на вопрос с порогом, оптимум можно найти двоичным поиском по .
Класс P (polynomial) – задачи, для которых существует алгоритм с полиномиальной сложностью . Сюда относятся сортировка, поиск кратчайшего пути, проверка связности графа, нахождение максимального потока и множество других задач.
Класс NP (nondeterministic polynomial) – задачи, для которых за полиномиальное время можно проверить предъявленное решение, даже если неизвестно, как быстро его найти. Например, подобрать набор предметов для рюкзака трудно, но если набор уже дан, достаточно сложить веса и ценности, чтобы убедиться в его пригодности. Важно не путать: NP означает не «неполиномиальная», а «недетерминированно полиномиальная», т.е. решаемая за полиномиальное время при возможности угадать верный вариант. Очевидно, что : если решение можно быстро найти, то можно и быстро проверить. А вот верно ли обратное, т.е. совпадают ли эти классы, – главный открытый вопрос информатики (проблема P vs NP, одна из «задач тысячелетия»). Большинство исследователей полагает, что , но доказательства нет.
Для сравнения задач между собой используют полиномиальную сводимость – уже знакомый нам приём приведения задачи. Говорят, что задача сводится к задаче (), если существует полиномиальный алгоритм, преобразующий любой экземпляр в экземпляр с тем же ответом. Смысл прост: если умеем решать , то умеем и , а значит, не проще .
NP-полные задачи – задачи из NP, к которым сводится любая другая задача из NP. Это самые трудные представители класса. В 1971 году Стивен Кук доказал, что такая задача существует: ей оказалась задача выполнимости булевой формулы (SAT). Далее, сводя SAT к другим задачам, а те – к следующим, к настоящему моменту NP-полными признали тысячи задач. Ключевое следствие: стоит найти полиномиальный алгоритм хотя бы для одной из них, как он немедленно появится для всех, и окажется, что . Отсюда же вытекает способ доказательства NP-полноты новой задачи: нужно свести к ней какую-либо известную NP-полную задачу, а также убедиться, что она сама лежит в NP. Без второго шага будет доказана лишь NP-трудность.
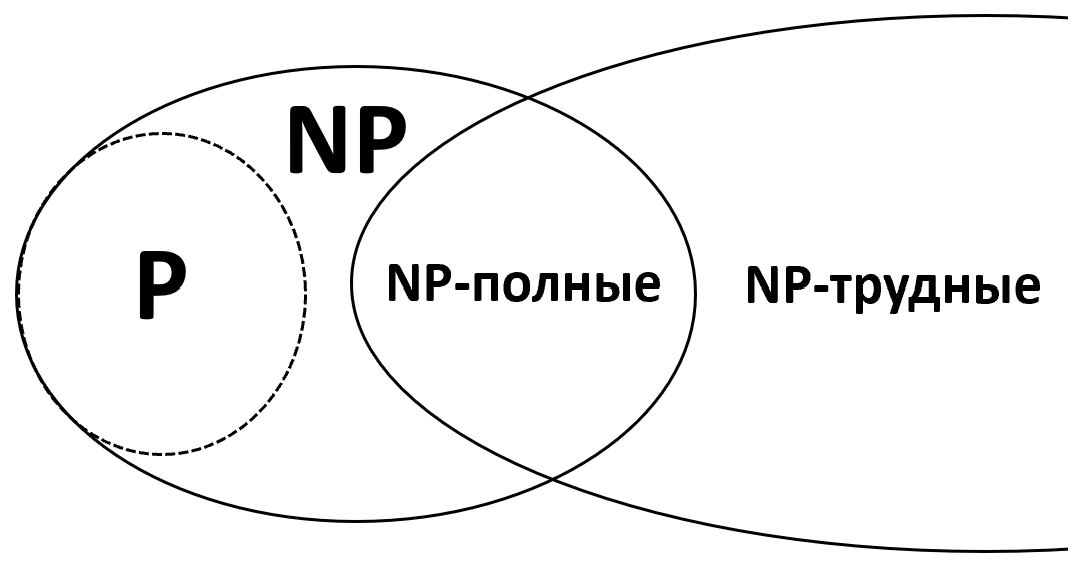
NP-трудные задачи – задачи, не проще любой задачи из NP, но сами в NP не обязательно входящие. Например, они могут не быть задачами распознавания. NP-полные задачи – частный случай NP-трудных: это в точности те из них, что лежат в NP. Поэтому одна и та же задача может корректно называться и так, и так. В частности, оптимизационная постановка задачи о рюкзаке является NP-трудной, а её распознавательный вариант с порогом – NP-полным, а значит, тоже NP-трудным. Соотношение классов иллюстрирует рисунок 26.
NP-трудность задачи не означает безнадёжности конкретного экземпляра. Мы уже решали задачу о рюкзаке динамическим программированием за псевдополиномиальные . Многие практические экземпляры имеют структуру, позволяющую отсечь основную массу вариантов. Именно на этом строятся точные методы вроде ветвей и границ. Но если экземпляр велик и лишён удобной структуры, остаётся отказаться от гарантии оптимальности в пользу приближённых методов. Приближённые методы тоже бывают разного типа. Простые эвристические алгоритмы способны получить решение почти моментально, но качество этого решения часто будет довольно далеко от оптимума. Более сложные же метаэвристические алгоритмы применимы для самых сложных экземпляров задач, т.к. позволяют балансировать затратами времени и качеством решения. Обо всех описанных подходах мы будем говорить далее.
9.3. Классические задачи
Задач дискретной оптимизации бесконечно много. Вот лишь некоторые, наиболее классические: о назначениях, о рюкзаке, о коммивояжёре, о размене, об упаковке в контейнеры, транспортная задача, различные варианты планирования. Все они формулируются в терминах простых понятных метафор (рюкзак, монеты, контейнеры), но охватывают бессчётное число практических приложений. Для некоторых существуют специфичные эффективные алгоритмы решения или эвристики.
Вернёмся к известной нам задаче о назначениях. Математическая модель данной задачи:
Здесь – элемент матрицы стоимостей размера , т.е. во что обойдётся поручение работы исполнителю . Булева переменная равна 1, если работа поручена исполнителю , и 0 в противном случае. Ограничения на суммы по строкам и столбцам требуют, чтобы каждая работа была поручена ровно одному исполнителю и наоборот. Допустимое решение задачи есть не что иное, как перестановка элементов, а мощность области допустимых решений равна . Уже при это порядка вариантов, так что полный перебор исключён. Однако задача решается точно за полиномиальное время, т.е. её распознавательный вариант лежит в классе .
Постановка симметрична: транспонирование матрицы стоимостей меняет местами роли исполнителей и работ, но не саму задачу. Требования квадратности матрицы и минимизации тоже не ограничивают общности, поскольку легко устраняются подготовкой входных данных:
- несбалансированная задача, в которой число работ и исполнителей не совпадает, дополняется фиктивными строками или столбцами с нулевой стоимостью;
- запрещённые назначения (исполнитель не умеет выполнять данную работу) кодируются заведомо большим числом в соответствующей ячейке;
- задача максимизации сводится к задаче минимизации, о чём будет сказано при разборе алгоритма решения.
Существуют и содержательные модификации задачи, не сводящиеся к базовой:
- задача о назначениях на узкое место (bottleneck assignment) – минимизируется не сумма стоимостей, а максимальная из них. Актуальна, когда работы выполняются параллельно и важен момент завершения последней;
- обобщённая задача о назначениях (generalized assignment problem) – каждый исполнитель обладает ограниченным ресурсом, каждая работа потребляет его в некотором объёме, и один исполнитель может взять несколько работ. По сути это набор связанных задач о рюкзаке, и она уже является NP-трудной;
- многоиндексная задача – назначение не пар, а троек и более (например, работа – исполнитель – интервал времени). Тоже NP-трудная.
Некоторые известные приложения задачи о назначениях:
- назначение водителей такси/каршеринга на заказы (Uber, Яндекс): стоимость = время подачи; матчинг происходит каждые несколько секунд;
- сопоставление ключевых точек между кадрами в компьютерном зрении;
- при трекинге объектов: сопоставление новых детекций с существующими треками;
- распределение задач по процессорам/ядрам, каналов по частотам;
- сопоставление записей о тех же сущностях из разных баз;
- назначение преподавателей на курсы/аудитории, судей на матчи;
- распределение рекламных слотов по рекламодателям.
Известный полиномиальный алгоритм решения базовой постановки задачи называется венгерским. Он базируется на представлении задачи как поиска паросочетаний в двудольном графе. Структура подобного двудольного графа обсуждалась в теме потоков в транспортных сетях. Основа метода – две леммы:
- Если веса всех рёбер двудольного графа, инцидентных какой-либо вершине, изменить (увеличить или уменьшить) на одно и то же число, то в новом графе оптимальное паросочетание будет состоять из тех же рёбер, что и в старом.
- Если веса всех ребер графа неотрицательны и некоторое полное паросочетание состоит из рёбер нулевого веса, то оно является оптимальным.
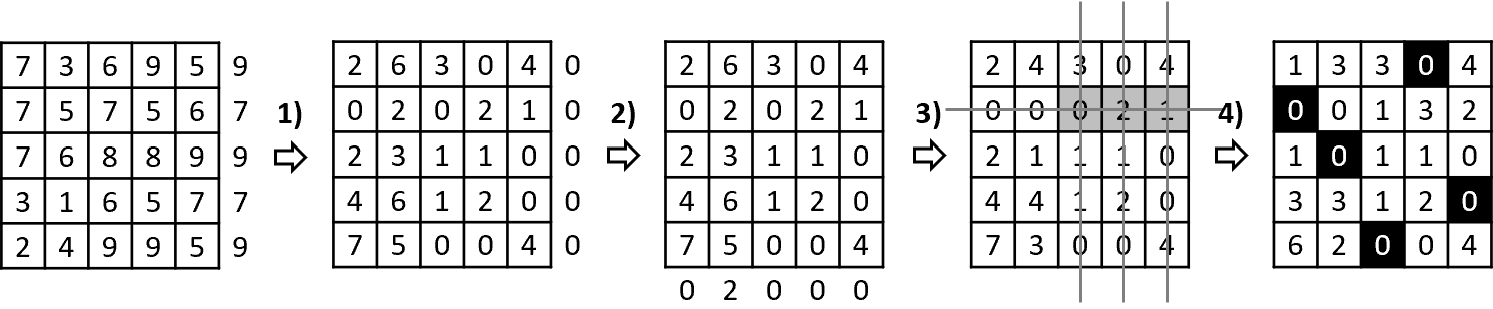
По сути венгерский алгоритм – это последовательное внесение изменений в матрицу стоимостей по лемме 1 вплоть до достижения ситуации, описанной леммой 2. Шаги алгоритма:
- Если требуется, свести задачу максимизации к задаче минимизации: найти в каждой строке матрицы ценности максимальное число и сформировать матрицу стоимостей, заполняя ячейки разницей максимального для строки числа и соответствующей ценности.
- Найти минимальный элемент в каждой строке и вычесть из каждого элемента соответственно.
- Найти минимальный элемент в каждом столбце и вычесть из каждого элемента соответственно.
- Вычеркнуть минимальное количество строк и столбцов, покрывающих все нулевые элементы матрицы. Среди оставшихся элементов найти минимальный, вычесть его из оставшихся элементов (которые не вычеркнуты) и прибавить к элементам, которые расположены на пересечении вычеркнутых строк и столбцов.
Шаг 4 повторяют до тех пор, пока количество вычеркнутых строк и столбцов не станет равным . Это признак того, что среди нулевых элементов существует полное паросочетание. Повторять шаги 2 и 3 не требуется, т.к. после шага 4 нулевой элемент гарантированно остаётся в каждой строке и каждом столбце. Сложность алгоритма составляет , что делает его пригодным даже для матриц в тысячи строк. На рисунке 27 представлены шаги алгоритма на примере конкретной матрицы ценностей. Цифры над стрелками соответствуют вышеуказанной нумерации шагов.
Транспортная задача является обобщением задачи о назначениях. Имеется поставщиков с запасами однородного товара и потребителей с потребностями , а также известна стоимость перевозки единицы товара от -го поставщика к -му потребителю. Требуется составить план перевозок , полностью вывозящий запасы и удовлетворяющий все потребности при минимальной суммарной стоимости. Задача о назначениях – её частный случай, в котором , а все запасы и потребности равны единице. Если суммарный запас не совпадает с суммарной потребностью, задачу балансируют, вводя фиктивного поставщика или потребителя, подобно фиктивным строкам и столбцам ранее.
Формально это задача линейного программирования с вещественными переменными, а не дискретная. Однако матрица её ограничений устроена так, что при целых и оптимальный план автоматически получается целочисленным, поэтому требование дискретности можно просто не накладывать. Задача принадлежит классу и решается методом потенциалов – специализацией симплекс-метода, учитывающей структуру ограничений (начальный план при этом строят методом северо-западного угла, минимального элемента или Фогеля). Альтернативно её сводят к задаче о потоке минимальной стоимости, что даёт полиномиальные алгоритмы общего назначения.
Задача о рюкзаке уже послужила нам примером при записи математической модели (27) и при обсуждении классов сложности. В оптимизационной постановке она NP-трудная. Задача примечательна ещё и тем, что её вариации покрывают едва ли не весь спектр рассматриваемых в главе методов:
- Неограниченный рюкзак – количество экземпляров каждого предмета не ограничено (в разделе 7.5 мы получали его решение из решения задачи 0-1 сменой порядка обхода в сжатом массиве); ограниченный – каждого предмета доступно не более штук. К первому варианту фактически сводится и задача о размене.
- Многомерный рюкзак – ресурс не один, а несколько (скажем, вес и объём), т.е. вместо одного ограничения-неравенства появляется группа.
- Задача о нескольких рюкзаках – предметы распределяются по нескольким вместилищам сразу, что роднит её с обобщённой задачей о назначениях и с задачей об упаковке в контейнеры.
- Дробный (непрерывный) рюкзак – предмет разрешается взять частично. Дискретность здесь теряется, и задача становится тривиальной: достаточно жадно брать предметы в порядке убывания удельной ценности , что даёт точный ответ за . Для обычной постановки тот же жадный принцип позволяет моментально получить приближённое решение.
Некоторые известные приложения задачи о рюкзаке:
- выбор инвестпроектов при ограниченном бюджете;
- отбор задач на спринт при гибком подходе к выполнению проекта;
- загрузка грузового транспорта/самолёта при ограничении по весу или объёму;
- распределение нагрузок в энергосети при лимите мощности;
- выбор пакетов или потоков для передачи при ограниченной полосе.
Задача об упаковке в контейнеры (Bin Packing) в некотором смысле противоположна задаче о рюкзаке: там вместимость была жёстким ограничением, а часть предметов оставалась невзятой, здесь же разместить требуется все предметы, а минимизируется количество затраченных контейнеров. Пусть имеется предметов размера и неограниченный запас контейнеров вместимостью каждый. Введём булеву переменную , равную 1, если предмет помещён в контейнер , и переменную , равную 1, если контейнер вообще задействован. Тогда модель принимает вид:
Первое ограничение не позволяет превысить вместимость и заодно связывает переменные: класть предметы можно только в задействованный контейнер. Второе требует, чтобы каждый предмет попал ровно в один контейнер. Очевидная нижняя оценка ответа – , т.е. число контейнеров при идеальной упаковке без пустот. Задача NP-трудная, причём труден даже вопрос о том, хватит ли двух контейнеров (это эквивалентно задаче о разбиении множества на две равные по сумме части). Поэтому на практике почти всегда применяют эвристики, а точные методы вроде ветвей и границ оставляют для небольших экземпляров.
Эвристики принято делить на две группы в зависимости от того, известен ли набор предметов заранее. Оперативные (online) получают предметы по одному и обязаны разместить каждый немедленно и безвозвратно, не зная, что поступит дальше:
- Next Fit (NF) – поддерживается лишь один открытый контейнер; не поместилось – контейнер закрывается навсегда и открывается новый. Требует дополнительной памяти, но расходует до контейнеров, где – оптимум;
- First Fit (FF) – предмет кладётся в первый контейнер из всех открытых, где помещается. Укладывается в ;
- Best Fit (BF) – предмет кладётся в наиболее заполненный из подходящих контейнеров, чтобы не дробить свободное место. Гарантия та же, что у FF, а на практике это обычно лучшая из оперативных эвристик;
- Worst Fit (WF) – противоположность предыдущей: предмет кладётся в наименее заполненный из подходящих. Замысел в том, чтобы не оставлять множество мелких непригодных пустот, а поддерживать в контейнерах крупные свободные участки под будущие большие предметы. На практике замысел себя не оправдывает: WF обычно уступает FF и BF, а его гарантия составляет те же , что и у примитивного NF.
Никакой оперативный алгоритм в принципе не может гарантировать лучше, чем примерно – это доказанная нижняя граница для данного класса, вытекающая из самой невозможности заглянуть вперёд.
Автономные (offline) эвристики располагают полным списком предметов и предполагают предварительную сортировку:
- First Fit Decreasing (FFD) – предметы сортируются по убыванию размера, после чего применяется First Fit;
- Best Fit Decreasing (BFD) – то же самое с Best Fit.
Обе расходуют не более контейнеров. Приведённые эвристики – пример приближённых алгоритмов с гарантией точности, в отличие от метаэвристик из последующих пунктов, которые дают решение лучшего качества, но без каких-либо гарантий.
Наиболее известные модификации задачи:
- многомерная упаковка – предметы и контейнеры характеризуются не одним размером, а двумя или тремя. Сюда относятся раскрой листового материала, укладка коробок на паллету, размещение блоков на кристалле;
- контейнеры разной вместимости или стоимости – тогда минимизируется не количество, а суммарная стоимость;
- задача раскроя (cutting stock) – по сути та же упаковка, но с большим числом одинаковых предметов, из-за чего перебор по отдельным предметам неэффективен и применяют метод генерации столбцов;
- упаковка с дополнительными ограничениями: на число предметов в контейнере, на совместимость предметов друг с другом, на порядок извлечения;
- задача о многопроцессорном расписании – контейнеров ровно (процессоров), а минимизируется максимальная загрузка. Формулировка обратна упаковке: там при заданной вместимости минимизировалось число контейнеров, здесь при заданном их числе минимизируется вместимость. Для неё работает аналог FFD: назначать задания по убыванию длительности наименее загруженному процессору.
Упомянутая задача о многопроцессорном расписании – лишь простейший представитель обширнейшего семейства задач планирования (scheduling). В общем виде требуется распределить работы по машинам (станкам, процессорам, исполнителям, аудиториям) и упорядочить их во времени наилучшим образом. Постановок здесь так много, что для их обозначения пользуются трёхпольной классификацией Грэхема , где перечисляются:
- – конфигурация машин: одна машина, несколько параллельных (идентичных или различающихся быстродействием) либо цеховая структура, описанная ниже;
- – дополнительные условия на работы: моменты поступления, директивные сроки, приоритеты, отношения предшествования, допустимость прерывания работы, затраты времени на переналадку машины;
- – критерий оптимальности: момент завершения последней работы , суммарное или взвешенное время завершения, максимальное запаздывание относительно сроков, количество просроченных работ.
Отдельно выделяют цеховые постановки, в которых каждая работа состоит из нескольких операций, и каждая операция выполняется на своей машине:
- flow shop (поточная линия) – все работы проходят машины в одном и том же порядке, как на конвейере. Определить нужно лишь очерёдность запуска работ;
- job shop (позаказное производство) – у каждой работы собственный маршрут по машинам. Наиболее близкая к реальному цеху и наиболее трудная постановка;
- open shop – маршрут не задан вовсе, порядок выполнения операций тоже подлежит определению.
Наиболее общей является задача календарного планирования проекта с ограниченными ресурсами (RCPSP), в которой работы связаны отношениями предшествования и потребляют возобновляемые ресурсы ограниченной мощности, а минимизируется срок завершения проекта в целом. Большинство перечисленных постановок, включая цеховые, представляют собой её частные случаи.
Практически все нетривиальные постановки NP-трудны: например, flow shop с двумя машинами решается точно алгоритмом Джонсона за , но уже с тремя машинами задача становится NP-трудной.
Задача о коммивояжёре (Travelling Salesman Problem, TSP) формулируется так: имеется городов и матрица стоимостей переезда между ними; требуется объехать все города, побывав в каждом ровно один раз, с минимальной суммарной стоимостью. В закрытой (замкнутой) постановке коммивояжёр обязан вернуться в исходный город, т.е. искомый маршрут представляет собой гамильтонов цикл; в открытой возврат не требуется, и достаточно гамильтонова пути. Открытая постановка сводится к закрытой добавлением фиктивного города, смежного всем остальным, причём стоимость переезда в него и из него равна нулю. Соседи фиктивного города в полученном решении станут концами искомого маршрута. Различают также симметричный вариант и асимметричный, где : так бывает при одностороннем движении или когда стоимость определяется не расстоянием, а временем либо расходом топлива. Отдельно выделяют метрический случай, в котором стоимости удовлетворяют неравенству треугольника, т.е. объезд никогда не выгоднее прямого переезда.
Задача NP-трудная, а её распознавательный вариант – вопрос о существовании гамильтонова цикла – NP-полный. Среди методов решения существует вариант динамического программирования (метод Хелда-Карпа) с оценкой . Это наилучшая известная оценка для худшего случая, но достигается она всегда, независимо от того, насколько удачен конкретный экземпляр. К тому же память расходуется в объёме . На практике из точных методов для относительно небольших экземпляров применяется метод ветвей и границ, который показывает себя эффективнее, хоть и не даёт лучших асимптотических гарантий. Для метрического случая существуют приближённые алгоритмы с гарантией: обход минимального остовного дерева даёт не более , а более тонкий алгоритм Кристофидеса – . В общем же случае, когда неравенство треугольника не выполняется, полиномиального алгоритма с какой бы то ни было постоянной гарантией точности не существует, если только . На практике применяют быстрые эвристики построения маршрута с последующим улучшением методами локального поиска или прочие продвинутые метаэвристические приближённые алгоритмы.
Из практически значимых обобщений отметим задачу маршрутизации транспорта (Vehicle Routing Problem): маршрутов несколько, у каждой машины ограничена вместимость, а у клиентов могут быть заданы временные окна доставки. В ней соединяются черты коммивояжёра, рюкзака и упаковки в контейнеры, и именно она стоит за построением маршрутов доставки в логистических сервисах.
9.4. Метод ветвей и границ
Метод ветвей и границ (Branch & Bound) дополняет полный перебор и динамическое программирование в списке точных методов решения задач дискретной оптимизации. Он заключается в последовательном выполнении двух процедур:
- ветвление (branching) – разбиваем множество допустимых решений на несколько подмножеств;
- нахождение границ (bounding) – находим оптимистичные оценки лучших решений для подмножеств и отсекаем заведомо бесперспективные.
Разбиение происходит рекурсивно вплоть до множеств мощности 1, т.е. конкретных решений. Таким образом, выполнение метода сводится к построению дерева обхода, где корень соответствует множеству всех допустимых решений, внутренние узлы – всё более мелким подмножествам, а листовые узлы – конкретным решениям. Фактически метод ветвей и границ является обобщением поиска с возвратом, который мы рассматривали ранее. Только в силу разницы задач к нарушению ограничений добавляется ещё одна причина для отсечения ветвей – по признаку бесперспективности. При разворачивании очередного узла эвристическая оценка нижней (в случае минимизации) границы целевой функции для его множества сравнивается с наилучшим на данный момент известным решением (его называют рекордом). Если оценка оказывается хуже, то дальнейшее разворачивание ветви прекращается.
Ключ к эффективности метода по сравнению с полным перебором – в отсечениях. Огромное количество решений не будет перебираться вовсе, т.к. они попали в множество, отброшенное по результатам проверки. Чем чаще и раньше будут происходить отсечения, тем эффективнее будет работать алгоритм. Основные способы на это повлиять – использовать точную эвристику нижней границы и изначально взять хорошее приближение за рекорд. Начальное приближение может быть получено рандомизацией или использованием простого эвристического метода (например, жадного алгоритма). Если же изначально рекорд отсутствует, то выгодно строить дерево в глубину, чтобы как можно быстрее добраться до первого решения и начать отсекать.
Порядок обхода дерева тоже подлежит выбору. Обход в глубину минимален по расходу памяти и быстро даёт первый рекорд. Альтернатива – разворачивать в первую очередь узел с наилучшей оценкой границы (best-first), что приводит к оптимуму за наименьшее число развёртываний, но требует держать в памяти все открытые узлы. Влияет и порядок ветвления: чем раньше рассматриваются переменные, сильнее влияющие на целевую функцию, тем раньше находится хороший рекорд и тем результативнее последующие отсечения.
Рассмотрим применение метода на экземпляре задачи о рюкзаке:
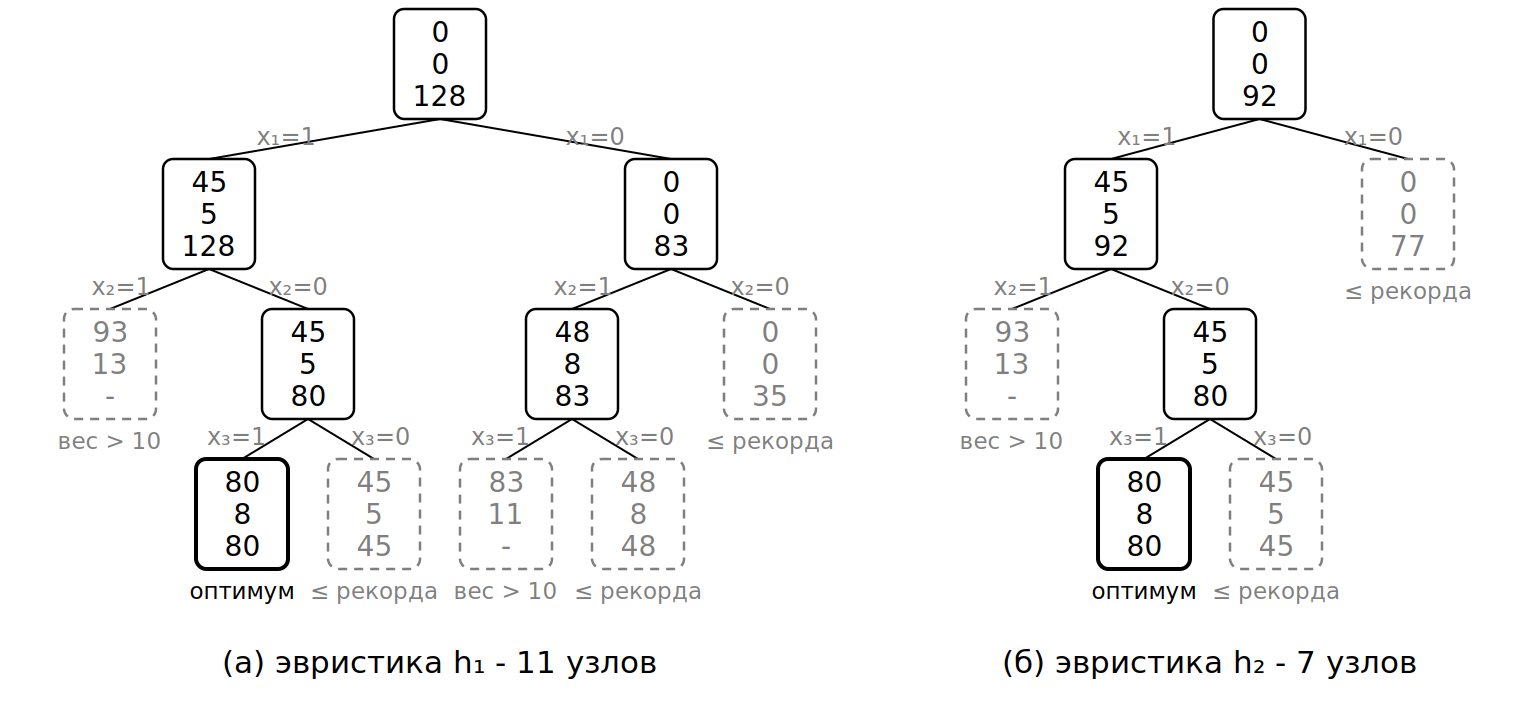
Сформулируем принцип ветвления следующим образом: на каждом -м уровне (нумерация с 1) разделяем множество на те решения, в которых -й предмет положен в рюкзак, и те, в которых не положен. Тогда глубина дерева для нашего экземпляра – 3. Будем строить дерево в глубину.
Т.к. решается задача максимизации, нам также нужна верхняя оценка ценности. Сформулируем её с помощью уже известного нам приёма релаксации. Напрашиваются два очевидных условия, которые могут быть отброшены: ограничение на вместимость (31) и требование целостности предмета (32). Обозначим варианты соответствующих эвристик и :
- равна сумме ценностей уже положенных предметов и тех, относительно которых ветвление ещё не производилось.
- равна сумме ценностей уже положенных предметов и решения дробной задачи для тех, относительно которых ветвление ещё не производилось. Последние рассматриваются в порядке убывания удельной ценности (отношения ) и берутся целиком, пока позволяет остаточная вместимость. От первого непоместившегося предмета берём часть, предполагая, что она несёт пропорциональную ценность.
На рисунке 28 изображены деревья, полученные при использовании двух разных эвристик. В узлах по порядку указаны: ценность уже положенного, вес уже положенного, оценка верхней границы. Как видно, второе дерево получилось существенно меньше. Всё потому, что эвристика точнее, и это позволило отсечь правое поддерево на раннем этапе.
Обратимся теперь к задаче о коммивояжёре. Общая схема метода остаётся прежней, но и ветвление, и оценка устраиваются иначе. Ветвиться удобно по рёбрам: выбирается ребро , и множество маршрутов разделяется на содержащие это ребро и не содержащие его. При этом появляются дополнительные поводы для отсечения по нарушению ограничений: у города не может оказаться более двух инцидентных выбранных рёбер, а выбранные рёбра не должны замыкать цикл раньше, чем в него войдут все города. Второй возможный принцип ветвления – наращивание частичного маршрута, когда на каждом уровне перебирается очередной посещаемый город. Эта схема ближе к поиску с возвратом, но даёт более широкое дерево.
Нижняя оценка стоимости в простейшем варианте получается так: к стоимости уже зафиксированной части маршрута прибавляется для каждого ещё не посещённого города стоимость самого дешёвого исходящего ребра. Маршрут обязан покинуть каждый город, и дешевле минимума это сделать нельзя. Более сильную оценку даёт метод Литтла, основанный на приведении матрицы стоимостей: из каждой строки вычитается её минимальный элемент, затем то же проделывается со столбцами, а сумма всех вычтенных величин и является нижней границей. Обоснование ровно то же, что и у леммы 1 венгерского алгоритма: маршрут содержит по одному ребру из каждой строки и каждого столбца, поэтому приведение уменьшает стоимость любого маршрута на одну и ту же величину. Ещё один способ опирается на минимальное остовное дерево: удаление любого ребра из замкнутого маршрута превращает его в остовное дерево, а значит, стоимость минимального остовного дерева заведомо не превосходит стоимости оптимального маршрута. Именно эта схема, дополненная автоматическим выводом дополнительных ограничений (метод секущих плоскостей, branch and cut), лежит в основе современных решателей, которым поддаются экземпляры в десятки тысяч городов.
Как было продемонстрировано ранее, использование более точной эвристики нижней границы позволяет эффективнее отсекать ветви. Однако более точная эвристика, как правило, вычислительно тяжелее. Её необходимо рассчитывать для каждого разворачиваемого узла дерева, и выигрыш быстро нивелируется. Особенно при высокой глубине, ведь на каждом последующем уровне всё больше узлов. Обойти это можно путём применения двух и более эвристик различной точности. При развёртывании узлов поверхностных уровней используется самая точная эвристика (а при наличии нескольких самостоятельных оценок – наиболее сильная из них, т.е. для нижней границы и для верхней): её расчёт вызывается небольшое число раз, а отсечения на этих уровнях дают на порядки больший выигрыш. По мере спуска глубже можно подменять эвристику на менее точную, но вычислительно эффективную: выигрыш от отсечений на этих уровнях уже небольшой, а количество вызовов оценки велико.
9.5. Локальный поиск
Метаэвристический алгоритм – это независимая от задачи стратегия верхнего уровня, которая управляет подчинёнными эвристиками, организуя поиск в пространстве допустимых решений так, чтобы за приемлемое время находить решения приемлемого качества без гарантий оптимальности.
Методы локального поиска относятся к траекторным метаэвристикам. «Траекторность» означает, что алгоритм последовательно обходит решения из пространства поиска по одному за раз (в отличие от популяционных, которые рассматривают сразу множество).
Т.к. пространство поиска рассматриваемых задач дискретно, его можно представить уже знакомым образом: в виде графа с узлами-состояниями (решениями). В задачах планирования рёбра графа олицетворяли действия, переводящие объект из состояния в состояние. В задачах оптимизации же заданных действий нет, поэтому для связности графа нам самим потребуется задать принцип смежности. Тогда можно было бы начать обход с любого узла и двигаться по смежным, руководствуясь стратегией, максимизирующей вероятность нахождения всё более оптимальных решений. Это и есть базовая концепция локального поиска.
Абстрактный алгоритм локального поиска выглядит следующим образом:
def local_search(F):
    # Начальное решение: случайное либо полученное простой эвристикой
    current = get_initial_solution()
    best = current # рекорд - лучшее из встреченных решений
    while условие останова не выполнено:
        neighbourhood = get_neighbours(current) # окрестность текущего решения
        candidate = select(neighbourhood) # выбор решения-кандидата
        if candidate == None:
            break # двигаться некуда
        if accept(candidate, current): # допустим ли переход в кандидата
            current = candidate
            if F(current) лучше F(best):
                best = current # обновление рекорда
    return best
Конкретные алгоритмы локального поиска различаются реализацией трёх подстановочных процедур: get_neighbours задаёт оператор окрестности, select определяет, какой из соседей рассматривается кандидатом, а accept решает, совершать ли переход, в том числе ухудшающий. Условиями останова алгоритма могут быть: достижение лимита итераций или времени, отсутствие улучшений в текущем рекорде уже продолжительное время и т.д.
Ключевое понятие для локального поиска – окрестность. Окрестность (соседство) некоторого решения – это множество решений, в некотором смысле близких к : они могут быть получены из минимальным изменением или разделяют большую часть его структуры. Как правило, окрестность задаётся перебором различных вариантов внесения небольшой правки вроде обмена, переноса, сдвига и т.д. Например, для задачи о рюкзаке соседние решения можно получать по таким принципам:
- перебором вариантов смены решения (класть / не класть) для одного предмета (one flip operator);
- как в предыдущем, но также меняем решение у случайного числа прочих предметов (one-N flip operator);
- случайным образом определяем, будем ли добавлять, обменивать или удалять предмет; делаем это со случайным предметом; повторяем раз, где – необходимый размер окрестности (swap, add or delete operator).
Аналогично, для задачи о назначениях могут использоваться такие окрестности:
- перебор вариантов смены исполнителей у двух задач (swap operator);
- перебор вариантов переноса задачи на другого исполнителя (move operator);
- перебор вариантов циклической смены назначений в подгруппах задач (rotate operator).
Для задачи о коммивояжёре окрестности строятся вокруг перестроения маршрута:
- 2-opt – из маршрута удаляются два ребра, а образовавшиеся два пути сшиваются обратно единственным другим возможным способом, что равносильно развороту участка маршрута;
- 3-opt – то же с тремя рёбрами, что даёт больше вариантов пересборки и более широкую окрестность ценой роста её размера;
- Or-opt – перенос участка из двух-трёх подряд идущих городов в другое место маршрута;
- алгоритм Лина-Кернигана – развитие идеи, при котором число обмениваемых рёбер не фиксировано, а определяется в процессе. До сих пор остаётся основой лучших эвристик для этой задачи.
Главное требование к оператору, задающему окрестность, – чтобы последовательным его применением можно было получить любую допустимую комбинацию. Иначе мы отбросим часть пространства поиска. Другой нюанс – должен ли оператор возвращать только решения, строго удовлетворяющие ограничениям. При сложных ограничениях реализация этого может быть вычислительно затратна. Тогда можно пойти по другому пути: ослабить ограничения, но переформулировать целевую функцию так, чтобы она штрафовала за их нарушение. Например, при минимизации целевую функцию можно задать таким образом:
Здесь – величина превышения ограничений, а – любая верхняя оценка целевой функции на допустимых решениях. При такой целевой функции любое допустимое решение будет заведомо лучше недопустимого. Это направит поиск к выходу на допустимые решения, которые уже будут соревноваться по значению изначального критерия. Часто применяют и более мягкий вариант , где – штрафной коэффициент.
Отдельного внимания заслуживает стоимость вычисления целевой функции. Окрестность просматривается на каждой итерации, поэтому пересчитывать для каждого соседа с нуля недопустимо дорого. Вместо этого вычисляют приращение, которое даёт конкретная правка: например, при обмене 2-opt из стоимости маршрута достаточно вычесть два удаляемых ребра и прибавить два добавляемых, что делается за вместо на полный пересчёт. Возможность дёшево посчитать приращение – серьёзный аргумент при выборе оператора окрестности.
Самый базовый алгоритм локального поиска – восхождение к вершине (hill climbing) (или спуск для минимизации). На каждой итерации он перемещается в лучшего из соседей, но только если тот лучше и текущего решения. Если такого нет, то алгоритм завершается – достигнут локальный экстремум. Застревание в локальных экстремумах является фундаментальной проблемой для всех поисковых оптимизационных алгоритмов. Для борьбы с этой проблемой и повышения вероятности обнаружить глобальный или просто более качественный экстремум алгоритм должен допускать неоптимальные шаги (в сторону ухудшения целевой функции). Наиболее просто это реализуется привнесением рандомизации. Вот некоторые возможные модификации:
- Стохастический (stochastic hill climbing) – из соседних состояний выбирается случайное, вероятность выбора зависит от крутизны. Сходится медленнее, но может найти лучшие решения на некоторых пространствах.
- С выбором первого варианта (first-choice hill climbing) – соседние состояния перебираются по очереди случайным образом. Выбирается первое попавшееся, которое лучше текущего.
- С перезапуском случайным образом (random-restart hill climbing) – последовательность поисков из случайного начального состояния.
Для проектирования эффективных метаэвристических алгоритмов важно понимать два класса проявляющихся в них свойств: эксплуатационные (exploitation) и исследовательские (exploration). Эксплуатационные свойства отражают нацеленность алгоритма на движение в сторону наиболее перспективных решений, обеспечивают сходимость. Обычный hill climbing – алгоритм только с такими свойствами. Потому он страдает от застревания в экстремуме и сильно уступает в качестве решения. Привнесение рандомизации в его модификациях повышает другие свойства – исследовательские. Они подталкивают алгоритм к исчерпывающему обходу пространства поиска, к рассмотрению всего его разнообразия. Чем в большее число областей сумеет заглянуть алгоритм, тем больше вероятность обнаружить глобальный экстремум. Однако алгоритм только с исследовательскими свойствами – просто случайное блуждание. Поэтому необходим баланс или даже динамическая подстройка этого баланса. И разные алгоритмы реализуют свои механизмы управления этим балансом. Общий для всех алгоритмов локального поиска способ добавить исследовательских свойств – привнесение случайности в оператор окрестности.
Метод имитации отжига (simulated annealing) – вариация локального поиска, вдохновлённая физическим процессом отжига металлов. Величина, семантически схожая с температурой, инициализируется положительным значением, после чего на каждой итерации падает (обычно по мультипликативному закону) вплоть до своего минимума. В рамках итерации из окрестности берётся случайный сосед, и вероятность перехода в него задаётся формулой:
Здесь – текущее решение, – выбранный сосед, – текущая температура, а – величина ухудшения целевой функции при переходе. Таким образом, неоптимальные ходы допустимы, но их вероятность тем выше, чем больше температура, и тем ниже, чем сильнее ухудшение целевой функции. Алгоритм начинает с активного исследования, но по мере падения температуры ведёт себя всё консервативнее, оседая в окрестности какого-то экстремума.
Алгоритму не требуется получение полной окрестности на каждом шаге, достаточно задать оператор внесения случайной модификации в решение. Это делает его довольно простым, но тем не менее эффективным для решения сложных задач.
Поиск с запретами – ещё одна модификация локального поиска. Для его минимальной реализации достаточно внести две корректировки в hill climbing:
- на каждом шаге происходит переход в лучшего соседа, даже если он хуже текущего решения;
- вводится список запретов (tabu list) из последних посещённых состояний для предотвращения зацикливаний.
Однако концепция внесения запретов намного шире простого исключения возврата в посещённые вершины. На самом деле это ещё один механизм стимулирования исследовательских свойств алгоритма. Запрет может накладываться не на конкретные состояния, а на определённые их признаки. Тогда алгоритм принудительно будет перебирать комбинации, сильнее отличающиеся от того, что он видел последнее время. Тем самым повышается разнообразие рассматриваемых решений, обход пространства поиска становится более обширным. Запрет снимается с течением времени или если запрещённый переход даёт новый рекорд.
Основные виды возможных запретов:
- запрет на перемещение – блокируется операция (переход), которая привела к текущему состоянию;
- частотный запрет – ведётся счётчик того, как часто определённый атрибут (например, присутствие конкретного ребра в графе или назначение ресурса задаче) встречался в решениях, при поиске запрещаются или получают высокий штраф атрибуты с высокой частотой использования;
- региональные запреты – если алгоритм долгое время топчется в одной области (целевая функция не улучшается), накладывается «запрет на область».
Некоторые возможные примеры для конкретных задач:
- задача коммивояжёра – запрет на использование рёбер, которые часто входили в состав текущих «лучших» маршрутов, чтобы заставить алгоритм строить пути через другие узлы (диверсификация);
- планирование (job shop) – запрет на смену порядка операций для конкретных станков на шагов, если эта комбинация привела к перегрузке или простою оборудования;
- упаковка в контейнеры – запрет на помещение определённого набора тяжёлых предметов в один контейнер, если попытка привела к нарушению ограничений по весу или неэффективному использованию объёма.
Локальный поиск с чередующимися окрестностями (Variable Neighborhood Descent) для противодействия застреванию в локальных экстремумах использует сразу операторов получения окрестности. Дело в том, что локальный экстремум относительно одной окрестности не обязательно является локальным экстремумом относительно другой. Но глобальный экстремум является локальным относительно любой окрестности, какую ни возьми. Тогда в процедуре обычного hill climbing при заходе в локальный экстремум достаточно переключиться на другую окрестность, что может позволить выбраться из тупика. Так последовательно перебираются все окрестностей. Если улучшения найти не удалось нигде – алгоритм завершается. Если же найти улучшение получилось – на следующей итерации рассмотрение снова начинается с применения самого первого оператора окрестности. Таким образом, алгоритм использует дополнительные окрестности для того, чтобы выбираться из тупиков, но остаётся вычислительно эффективным, т.к. не рассматривает их все каждый раз, а разворачивает только по необходимости.
9.6. Базовые сведения о популяционных метаэвристиках
В противовес траекторным методам выделяют популяционные метаэвристики. На каждом своём шаге такие методы рассматривают целое множество (популяцию) решений. Как правило, это позволяет более исчерпывающе осмотреть пространство поиска и повышает вероятность найти более качественный экстремум.
Процедуру локального поиска можно доработать до лучевого поиска (local beam search), базовые шаги которого:
- случайным образом берётся начальных состояний;
- для каждого из состояний разворачивается его окрестность;
- из объединённого множества окрестностей отбирается наиболее оптимальных состояний, которыми замещаются исходные.
Шаги 2–3 повторяются до достижения условий останова. Как можно заметить, hill climbing является вырожденным частным случаем лучевого поиска при . Отбор лучших из общего пула быстро приводит к скапливанию состояний в одной области пространства поиска. Поэтому применяют стохастический вариант (stochastic beam search), в котором состояния отбираются случайно, но с вероятностью, зависящей от их качества. В таком виде лучевой поиск оказывается уже совсем недалеко от генетических алгоритмов.
Категоризация на траекторные и популяционные метаэвристики слегка размыта. Классические популяционные алгоритмы предполагают механизмы обмена информацией между некими агентами, формирующими отдельные решения. Поэтому лучевой поиск не всегда классифицируют как популяционный метод. К полноценным популяционным метаэвристикам среди прочего относят генетические алгоритмы, алгоритм муравьиной колонии, пчелиный алгоритм, алгоритм роя частиц и другие.
Многие популяционные метаэвристики вдохновлены явлениями, наблюдаемыми в живой природе, физических процессах, социуме. Генетические алгоритмы имитируют естественный отбор. Решение здесь называют особью и кодируют в виде хромосомы – последовательности генов. Для дискретных задач кодирование обычно очевидно: битовая строка для задачи о рюкзаке, перестановка для коммивояжёра или назначений. Популяция из некоторого числа особей за одну итерацию (поколение) проходит следующие этапы:
- оценка приспособленности (fitness) каждой особи; роль этой оценки обычно играет целевая функция;
- селекция – отбор особей в родители, причём тем вероятнее, чем выше приспособленность (турнирный отбор, метод рулетки);
- скрещивание (кроссовер) – порождение потомков, наследующих части структуры обоих родителей;
- мутация – внесение в потомка небольшого случайного изменения, т.е. по сути применение оператора окрестности;
- формирование нового поколения из потомков и части прежней популяции. Гарантированное сохранение в нём нескольких лучших особей называют элитизмом. Размер популяции служит ещё одним регулятором баланса: чем она больше, тем разнообразнее охват пространства поиска, но тем дороже обходится каждое поколение.
Именно кроссовер отличает генетические алгоритмы от всего рассмотренного ранее. Он позволяет совмещать фрагменты решений, уже показавших свою состоятельность. Основная практическая сложность – подобрать кодирование и операторы так, чтобы потомки оставались допустимыми решениями. Например, для перестановок побитовый обмен участками хромосом непригоден, поскольку в маршруте появятся повторяющиеся и пропущенные города, поэтому применяют специальные операторы вроде упорядоченного кроссовера.
Другое большое семейство метаэвристик – основанные на поведении различных стайных существ. Часто такие алгоритмы называют роевым интеллектом. Все подобные алгоритмы устроены схожим образом: на каждой итерации отдельные особи параллельно конструируют свои решения, но тем или иным образом учитывают информацию от сородичей. К примеру, в алгоритме муравьиной колонии (Ant Colony Optimization) имитируется передача информации о перспективных вариантах при помощи феромонов. Каждый муравей заново строит маршрут коммивояжёра, выбирая очередной город случайным образом, но тем вероятнее, чем больше феромона отложено на соответствующем ребре и чем короче само это ребро. По завершении итерации феромон добавляется на рёбра, вошедшие в удачные маршруты, и частично испаряется со всех рёбер сразу. Испарение играет важнейшую роль: без него колония быстро зафиксировалась бы на первом же приемлемом решении. Отметим, что решение здесь не правится, а конструируется заново на каждой итерации, чем метод принципиально отличается и от локального поиска, и от генетических алгоритмов.
В алгоритме роя частиц (Particle Swarm Optimization) особи-частицы перемещаются по пространству поиска, и каждая корректирует направление своего движения в сторону лучшей из найденных ею самой позиций и лучшей позиции, найденной роем в целом. Изначально метод создан для непрерывной оптимизации, поэтому применение его к дискретным задачам требует переосмысления понятий скорости и перемещения.
Прочие алгоритмы этого семейства – пчелиный, светлячковый, летучих мышей и десятки других – различаются главным образом биологической метафорой, тогда как лежащие в их основе механизмы повторяются: случайное порождение вариантов, усиление удачных, забывание давних.
Метаэвристических алгоритмов существует очень много, но ни один не превосходит все прочие на всём многообразии задач: выигрыш на одном классе задач неизбежно оплачивается проигрышем на другом. К тому же ключом к эффективному алгоритму часто является не столько выбор правильного подхода, сколько настройка параметров: закона охлаждения, длины списка запретов, размера популяции, вероятности мутации и т.д., причём удачные значения, найденные для одного экземпляра задачи, переносятся на другие лишь ограниченно.
9.7. Многокритериальная оптимизация
В рассмотренных ранее подходах предполагалось, что целевая функция единственна. Однако во многих практических задачах необходимо добиться оптимизации сразу по нескольким критериям. Формально целевая функция становится вектор-функцией , а понятие оптимума теряет прежнюю однозначность: многие решения оказываются несравнимы друг с другом, т.к. выигрыш по одному критерию может соседствовать с проигрышем по другому, если критерии конфликтуют. Если же конфликта нет, задача вырождается в однокритериальную, ведь решение, оптимальное по одному критерию, окажется оптимальным и по остальным. Существуют два направления методов разрешения этой неоднозначности. Первые стремятся всё-таки прийти к единственному итоговому решению, соответствующим образом организовав процедуру или переформулировав задачу. Вторые нацелены на то, чтобы отсеять все заведомо неудачные решения и оставить так называемые Парето-оптимальные, среди которых окончательный выбор делается человеком, эвристикой или любым другим способом.
Многокритериальную задачу можно свести к однокритериальной путём превращения всех критериев, кроме одного, в ограничения. Допустим, решая задачу построения инвестиционного портфеля, можно задать максимальный допустимый уровень риска и максимизировать прибыльность. А можно задать минимальный достаточный уровень прибыльности и минимизировать риск.
Если критерии упорядочить по приоритетности, то можно свести задачу к цепочке последовательных оптимизаций. Сначала оптимизируется главный критерий, затем следующий без ухудшения уже достигнутых и т.д. Такой подход называют лексикографической оптимизацией. Он может быть адекватен, если присутствует подобная строгая градация, где одни критерии заведомо важнее прочих. Однако строгое требование не ухудшать уже достигнутое нередко обесценивает все последующие шаги: если оптимум по главному критерию единственен, то оптимизировать остальные уже негде. Поэтому чаще применяют метод уступок, допускающий ухудшение ранее оптимизированных критериев в пределах заданной величины.
Несколько критериев могут быть сведены к одному тремя основными способами:
- аддитивная свёртка – ;
- мультипликативная свёртка – ;
- расстояние в пространстве критериев от идеального решения (на примере евклидова) – .
Здесь – число критериев, – веса их важности, – нормированные значения целевых функций, – идеальные (наилучшие достижимые) значения каждого критерия по отдельности. Нормировка здесь критична, т.к. иначе критерии, измеримые в более мелких величинах, практически не будут никак влиять на результат. Обычно применяют приведение к отрезку по формуле , которое заодно позволяет привести все критерии к одному направлению оптимизации. На практике , и часто оцениваются приближённо.
Аддитивная свёртка допускает компенсацию: провал по одному критерию может быть возмещён успехами по остальным. Мультипликативная этого не позволяет, ведь нулевой множитель обращает в нуль всё произведение, поэтому её применяют, когда ни один из критериев не должен проваливаться совсем. Метод расстояния до идеала склонен выдавать сбалансированные по критериям решения. Стоит также знать, что аддитивная свёртка ни при каких весах не выявит решений, лежащих на невыпуклых участках фронта Парето, о котором речь пойдёт далее.
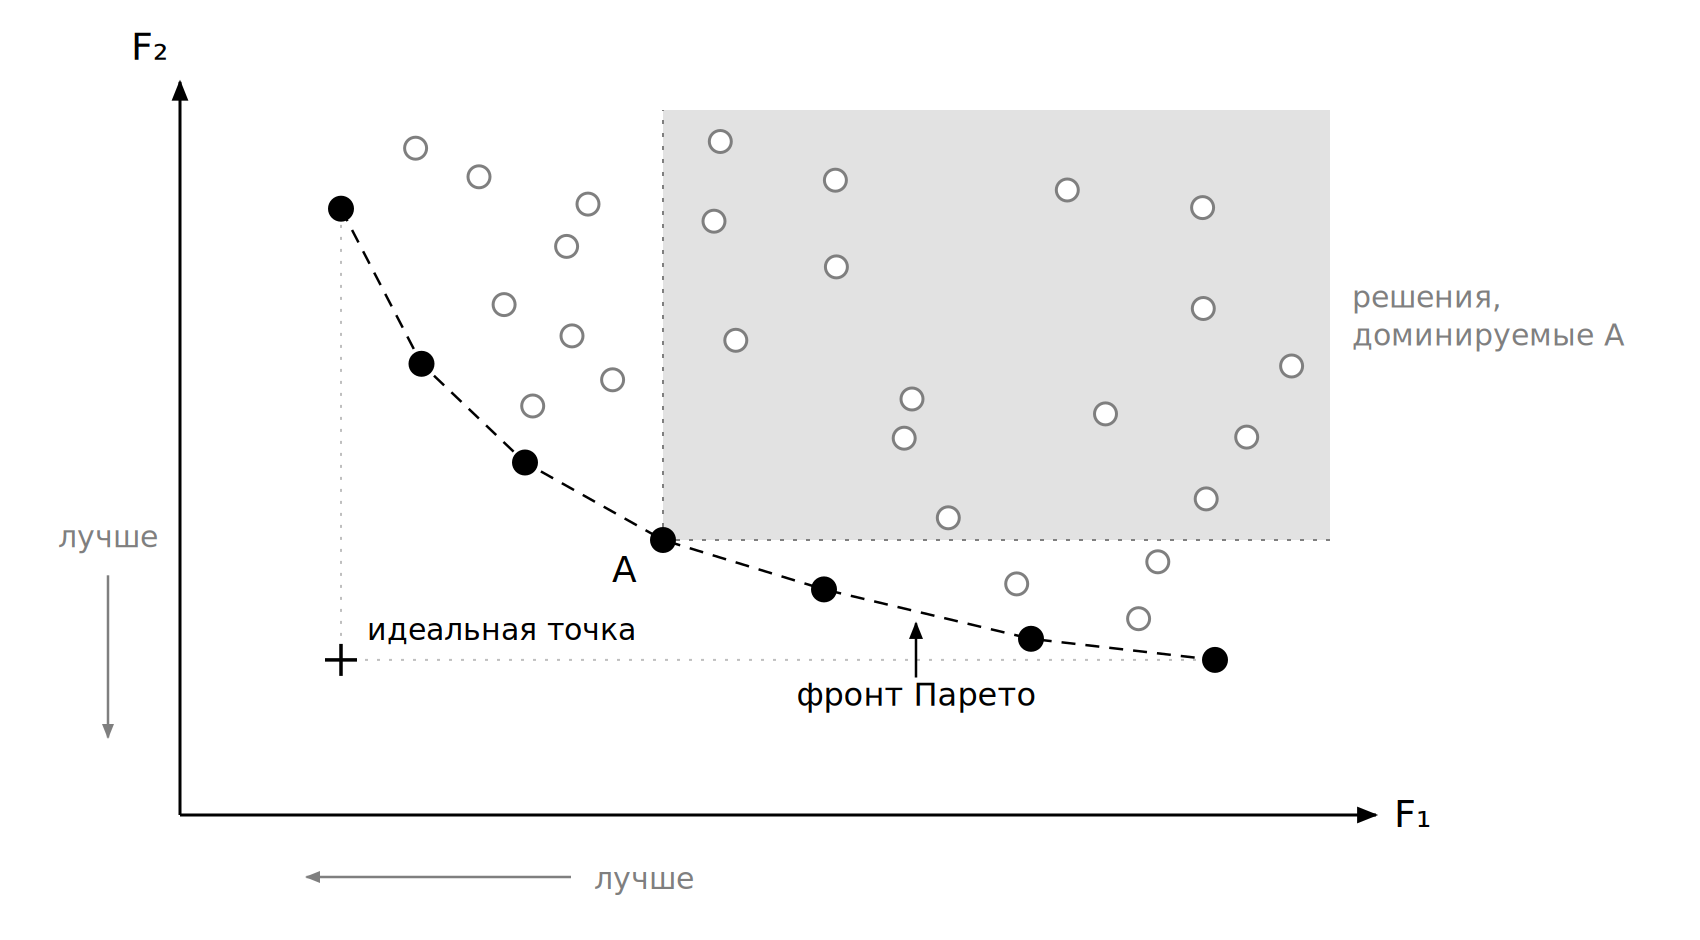
Второй класс методов стремится отбросить все доминируемые решения. Решение доминирует по Парето над решением , если не хуже ни по одному критерию и лучше хотя бы по одному. Оставшиеся решения называют Парето-оптимальными. Если представить многомерное пространство критериев, где каждая ось – отдельный критерий, то точки, соответствующие таким решениям, будут лежать на так называемом фронте Парето (рисунок 29). В дискретном случае его также называют множеством Парето. Число Парето-оптимальных решений может быть огромным и расти экспоненциально с размером задачи, поэтому на практике ищут не весь фронт, а его представительную аппроксимацию.
На базе принципа Парето основаны многие специализированные многокритериальные модификации метаэвристик: генетических алгоритмов (NSGA-II, NSGA-III, SPEA2), алгоритма муравьиной колонии, роя частиц и некоторых других. Как правило, они оценивают жизнеспособность решения на основе количественного анализа отношений доминирования с прочими решениями. Другим частым усложнением является использование кластеризации или других способов отсева близких по свойствам решений и поддержания разнообразия в популяции. Иначе в результирующем множестве могут оказаться решения, сконцентрированные в узкой области фронта Парето, т.е. решения с близким балансом критериев.
Окончательный выбор из полученного множества недоминируемых решений, если он требуется, остаётся за человеком либо за одним из методов многокритериального выбора, разработанных для этой цели: TOPSIS, метода анализа иерархий и прочих.
9.8. Выводы
Обозначим порядок выбора метода решения. Если для задачи известен специализированный полиномиальный алгоритм, как венгерский для назначений, применяют его. Иначе на небольших экземплярах работают точные методы, а с ростом размерности приходится переходить к эвристикам и метаэвристикам, разменивая гарантию оптимальности на приемлемое время работы.
Отметим также, что реализовывать рассмотренные методы вручную необязательно. Все описанные алгоритмы давно реализованы в промышленных решателях и библиотеках: CPLEX, Gurobi, OR-Tools и множестве других. От пользователя требуется формально описать модель задачи и выбрать подходящий метод, поэтому основные усилия на практике уходят на построение модели, а не на программирование алгоритма.