11. Технологии игрового ИИ и симуляций
11.1. Общие сведения
От ИИ виртуального агента в игре или симуляции требуется не оптимальность, а правдоподобность, «человечность» поведения. Кроме того, система реального времени требует высокой производительности: при кадровой частоте в 60 FPS на один кадр есть всего 16.6 мс. Причём очень большой ресурс неизбежно занимают отрисовка графики, обсчёт физики и прочие базовые задачи. Эти и другие особенности определили своеобразие данной области ИИ и сформировавшихся в ней подходов.
Поведение любого виртуального агента можно высокоуровнево описать как повторяющийся цикл: восприятие окружающей информации, мышление, действие. На поведение могут влиять состояние персонажа, его знания о мире и эмпирический опыт, цели и т.д. Отсюда и разнообразие сложившихся подходов.
Отдельное примечательное применение ИИ в играх – процедурная генерация, т.е. замена ручного труда специалистов алгоритмической генерацией миров, ассетов и т.д.
Глава представляет собой концептуальный обзор, достаточный для ориентации в теме, но за деталями следует обращаться к специализированным источникам: книгам I. Millington «AI for Games» и G. Yannakakis, J. Togelius «Artificial Intelligence and Games», а также докладам разработчиков с конференции GDC (gdcvault.com).
11.2. Принятие решений
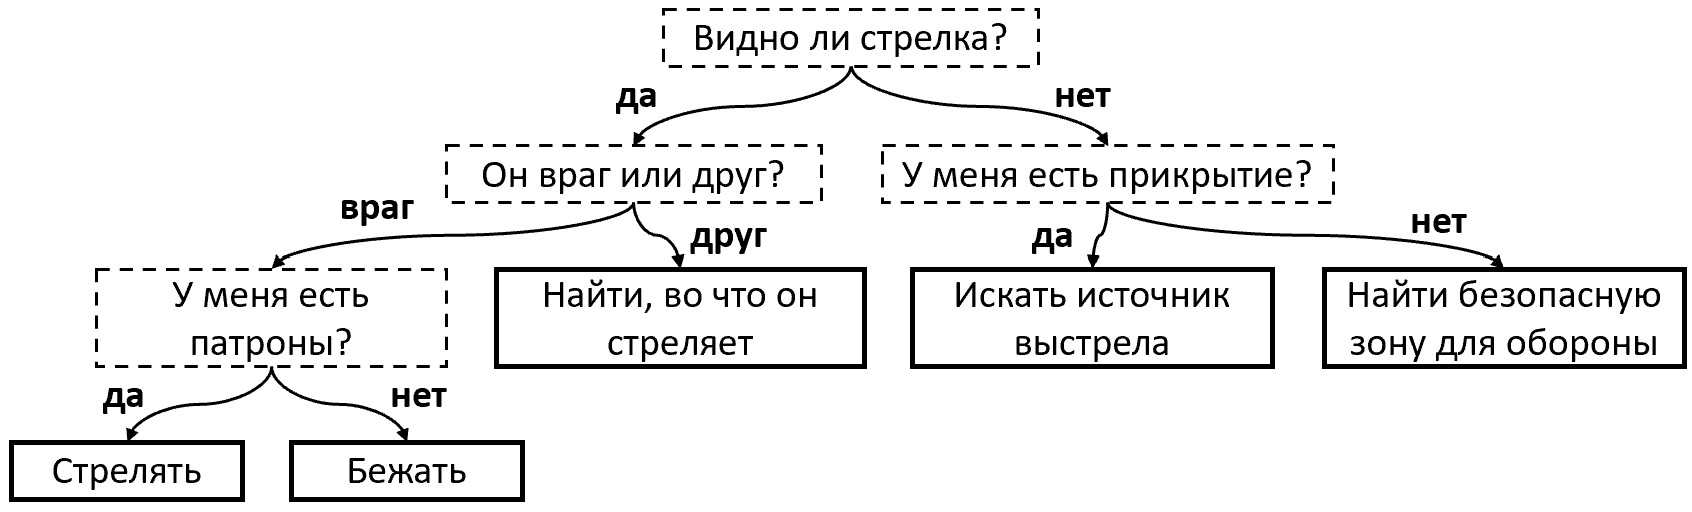
Логика поведения примитивного агента может быть реализована на простых условных операторах. И в каких-то случаях этого даже будет достаточно. Однако это очень неудобный, трудно масштабируемый и трудно переносимый способ. Множество вложенных if-ов можно заменить на более удобное структурированное представление – дерево решений (не путать с похожей моделью из сферы машинного обучения). Это древовидная структура, каждый внутренний узел которой соответствует проверке условия, дочерние ветви соответствуют различным исходам, а листовые узлы – вариантам поведения (рисунок 35). Дерево решений позволяет реализовать data-driven подход (управление на основе данных): логика различных узлов может быть написана заранее, а структура дерева храниться во внешних данных, а не в коде. Тогда разработчикам ИИ становится удобно экспериментировать с поведением, для этого не потребуется переписывать код.
Для моделирования деятельности агента удобно ввести концепцию дискретных состояний, которые определяют его поведение. Наиболее общеупотребимая модель, основанная на данной концепции, – конечный автомат (Finite-State Machine). Это граф с узлами-состояниями и рёбрами-переходами между ними. Основные концепции:
- состояния (states) – дискретные режимы поведения (например, «Патрулирование», «Преследование», «Атака», «Поиск укрытия»);
- переходы (transitions) – правила смены состояния при выполнении условий (Если вижу врага И здоровье > 50%, То переход из «Патрулирование» в «Атака»);
- события (events) – внешние или внутренние триггеры, проверяемые условиями перехода (игрок замечен, здоровье упало, закончились патроны).
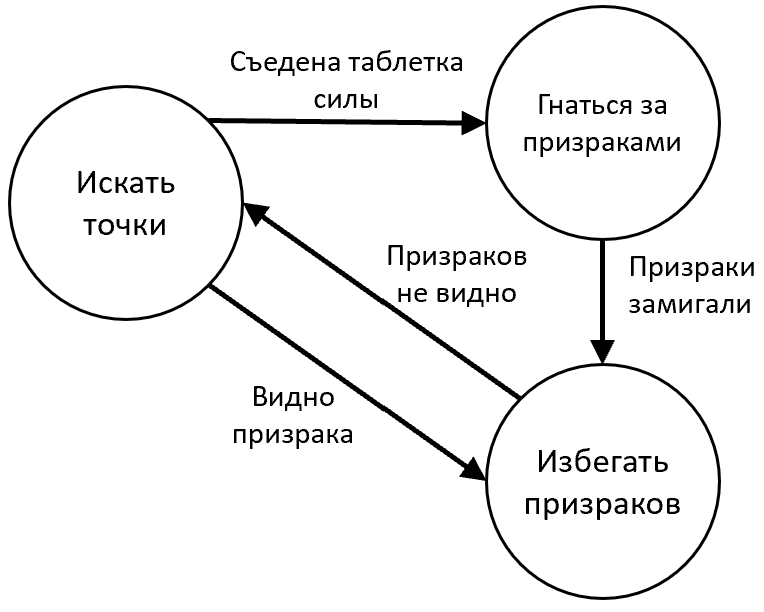
На рисунке 36 приведён пример простейшего конечного автомата с тремя состояниями из игры Ms. Pac-Man. Для сколько-либо изощрённого поведения потребуется гораздо более крупный конечный автомат. Первая часть Half-Life впечатляла уровнем ИИ противников, и даже по сегодняшним меркам её ИИ выглядит убедительно. Для этого потребовался конечный автомат, насчитывающий более 80 состояний (у конкретных персонажей присутствуют не все сразу).
Техническая реализация конечного автомата может быть различной. В примитивном случае бывает достаточно простого оператора switch. Но масштабируемый подход в духе ООП – реализация паттерна Состояние (State). Для прерываемого поведения практикуется стековая реализация (муравей ищет еду, но убегает от опасности – бегство временно останавливает поиск): новое состояние кладётся на верхушку стека, а после его извлечения восстанавливается старое. Ещё один подвид конечного автомата – иерархический. В нём макросостояние само моделируется конечным автоматом с подсостояниями. Например, у состояния «не в бою» могут быть подсостояния «патрулирование» и «безделье». Наконец, переходы между состояниями могут быть вероятностными или нечёткими (Fuzzy FSM).
Помимо ИИ виртуальных агентов конечный автомат может использоваться для проектирования переходов между уровнями и экранами, реализации сложных квестов, моделирования поведения динамических объектов вроде бомб, дверей, ловушек и многого другого.
Главный недостаток конечного автомата заключается в комбинаторном росте числа переходов (при состояниях их до ). Большой автомат трудно поддерживать. Кроме того, перенести уже реализованное поведение на нового агента по частям затруднительно. Эти недостатки устраняет другая структура – дерево поведения (Behavior Tree, BT). Эта модель предполагает, что выбор поведения реализуется путём обхода в глубину соответствующего дерева.
Каждый узел BT возвращает родителю один из трёх статусов: выполняется (Running), успех (Complete) либо провал (Failed) – узел недоступен для текущего состояния ИИ или игры и не может выполниться. Некоторые реализации добавляют ещё два: ошибка (Error) при сбое проверки и выбран (Selected) для узла, поддерево которого обходится в данный момент.
Типы узлов BT:
- корень;
- действие / лист – действие или атомарное поведение;
- управляющий – задаёт правила обхода, но не содержит самого поведения, его статусы чаще всего собираются из статусов растущего из него поддерева:
- селектор (Selector) – опрашивает детей слева направо и возвращает успех, как только успех вернул очередной ребёнок; если неудачу вернули все, возвращает неудачу;
- последовательность (Sequence) – опрашивает детей слева направо и возвращает неудачу, как только неудачу вернул очередной ребёнок; если успех вернули все, возвращает успех;
- параллельный узел (Parallel) – параллельно запускает своих потомков.
Селектор и последовательность прекращают опрос детей, как только исход предопределён: селектору достаточно одного успеха, последовательности – одной неудачи. Остальные дети в этом случае не опрашиваются вовсе.
Отдельного внимания заслуживает статус «выполняется». Если его вернул очередной ребёнок, управляющий узел тоже немедленно прекращает опрос и возвращает родителю «выполняется». Так статус поднимается до самого корня, а на следующем такте обход возобновляется с запомненного узла. Именно это отличает дерево поведения от дерева решений: лист BT – не мгновенный выбор ветви, а действие, растянутое на множество кадров (подойти к укрытию, проиграть анимацию перезарядки).
Логику опроса удобно записать одной рекурсивной функцией, вызываемой для корня дерева на каждом такте (тике):
def tick(node, agent):
    if node является листом:
        # Действие возвращает RUNNING, COMPLETE или FAILED
        return выполнить действие узла для agent
    if node является селектором:
        for each child, потомок node слева направо:
            status = tick(child, agent)
            if status != FAILED:
                # Успех или выполнение – остальных детей не опрашиваем
                return status
        return FAILED
    if node является последовательностью:
        for each child, потомок node слева направо:
            status = tick(child, agent)
            if status != COMPLETE:
                # Неудача или выполнение – остальных детей не опрашиваем
                return status
        return COMPLETE
Параллельный узел для краткости опущен: он опрашивает всех детей, а итоговый статус собирает из их статусов по заданной политике.
Отдельную роль играют декораторы – обёртки над узлом (в одних реализациях это самостоятельный тип узла, в Unreal Engine – сущность, накладываемая на узел). Декораторы условий проверяют, находится ли агент в подходящем состоянии и актуально ли поведение, описываемое поддеревом под декоратором; если нет, поддерево не обходится вовсе. Декораторы контроля вмешиваются в результат обхода: Succeeder подменяет статус узла на успех (Complete), Inverter инвертирует его, а Repeater перехватывает завершение узла и запускает его заново.
BT обычно статичны: не имеют состояния, хранятся в памяти в единственном экземпляре, а не для каждого агента. Состояние среды и состояние обхода дерева для каждого агента должны храниться во внешней памяти – Blackboard, о котором подробнее будет сказано далее. На рисунке 37 приведён пример простого BT. Ромбами обозначены декораторы условий.
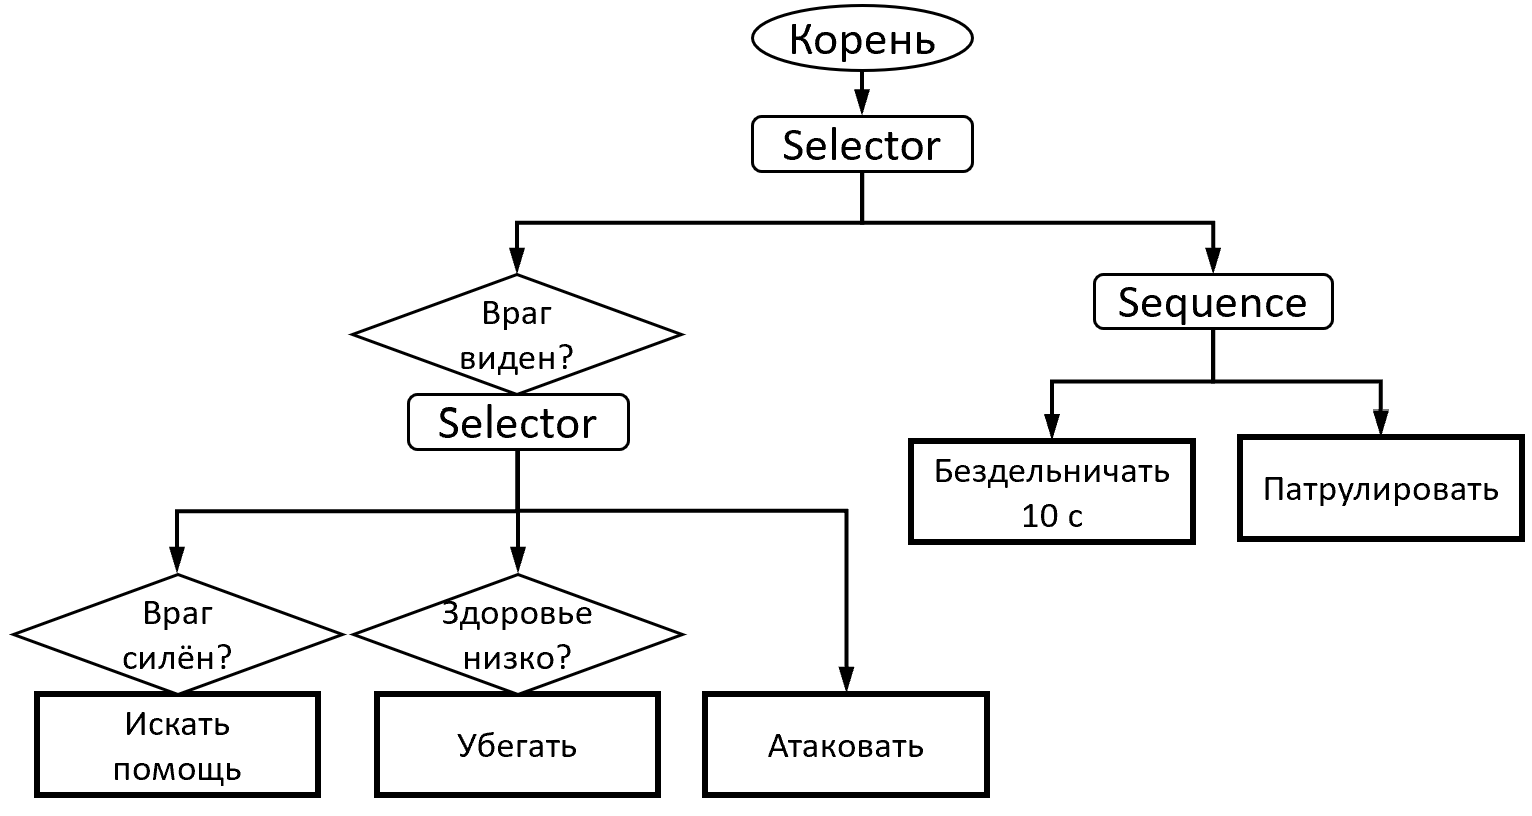
Древовидная структура позволяет легко комбинировать существующие наработки при проектировании ИИ новых агентов. Для этого достаточно подвесить поддерево, реализующее определённый спектр поведения агента, в нужное место его BT. Структура вышележащих уровней задаст логику перехода агента к этому поведению. Кроме того, параметры поведения могут быть настраиваемыми, а сама подстановка поддерева может осуществляться динамически.
BT являются базовым, наиболее распространённым подходом для реализации ИИ в играх. Вот лишь некоторые примеры использования: Halo 2–3, Alien: Isolation, Bioshock, Bioshock: Infinite, Spore, Death Stranding. Дерево поведения поддерживается и самими движками: в Unreal Engine оно встроено штатно, в Unity доступно официальным пакетом Unity Behavior.
Рассмотренные до этого момента модели явно задавали условия смены состояния/поведения. Однако возможен более гибкий подход, когда принятие решения завязано на численной оценке полезности альтернатив для агента. Выбирается то, что имеет наибольшую оценку полезности в данный момент. Такой подход называется Utility AI. В формулах расчёта полезности можно учесть любые необходимые факторы, а подбором параметров в формулах можно добиться самого разнообразного поведения. В таблице 6 приводятся принципы расчёта полезности, позволяющие добиться поведения, схожего (но не эквивалентного) с примером BT выше.
Пусть – доля оставшегося здоровья, – оценка превосходства врага, – время, проведённое в ожидании, в секундах, а – доля непройденного маршрута патрулирования. Каждый такой фактор нормируется в диапазон своей кривой отклика (response curve), а полезность действия собирается из приоритета и значений его факторов:
Таблица 6. Utility AI: факторы и кривые отклика
| Действие | Факторы | |
|---|---|---|
| Искать помощь | 1,0 | враг видим; – опасность; – превосходство врага |
| Убегать | 0,9 | враг видим; – опасность |
| Атаковать | 0,8 | враг видим; – боеготовность |
| Бездельничать | 0,5 | – незавершённость ожидания |
| Патрулировать | 0,5 | – остаток маршрута |
Форма каждой кривой подобрана по смыслу фактора. Боеготовность растёт линейно вместе со здоровьем. Опасность – квадратично: пока здоровья много, она почти не влияет на решения, а у нижней границы резко возрастает. Превосходство врага пропущено через логистическую кривую с крутизной и точкой перегиба : пока силы примерно равны, звать на помощь почти бессмысленно, но при заметном превосходстве врага фактор быстро выходит на единицу. Наконец, «враг видим» – булев фактор, т.е. вырожденная кривая-ступенька, мгновенно переключающаяся между 0 и 1. Обычные условия, которыми оперировали предыдущие модели, оказываются частным случаем кривой отклика.
Подход Utility AI хорошо сочетается с рандомизацией: решение можно принимать случайно, но с вероятностями выбора альтернатив, пропорциональными их полезности.
Наиболее известный пример реализации Utility AI – серия игр The Sims.
11.3. Поиск и планирование
В моделях предыдущего раздела очередное действие выбирается по текущему состоянию мира. Но часть задач требует заглянуть вперёд – просчитать последствия своих действий, предугадать ответ противника, выстроить цепочку шагов к отдалённой цели. Общий аппарат для этого – поиск в графе состояний, рассматривавшийся ранее.
Минимакс (Minimax) – принцип принятия решения, исходящий из стратегии пессимизма: выбирается вариант, при котором максимальные возможные потери минимальны. Применительно к играм это означает, что мы предполагаем наихудшее: противник в ответ на любой наш ход поступит наилучшим для себя образом.
Метод применим, когда игру можно сформулировать как игру с нулевой суммой: выигрыш одного игрока в точности является проигрышем другого. Классические примеры – шашки, шахматы, крестики-нолики, пошаговые тактические бои. Для работы алгоритма необходимо ввести метрику выигрышности позиции (некие очки). Тогда наш игрок, называемый MAX, стремится эту метрику максимизировать, противник (MIN) – минимизировать, а ничья соответствует нулю.
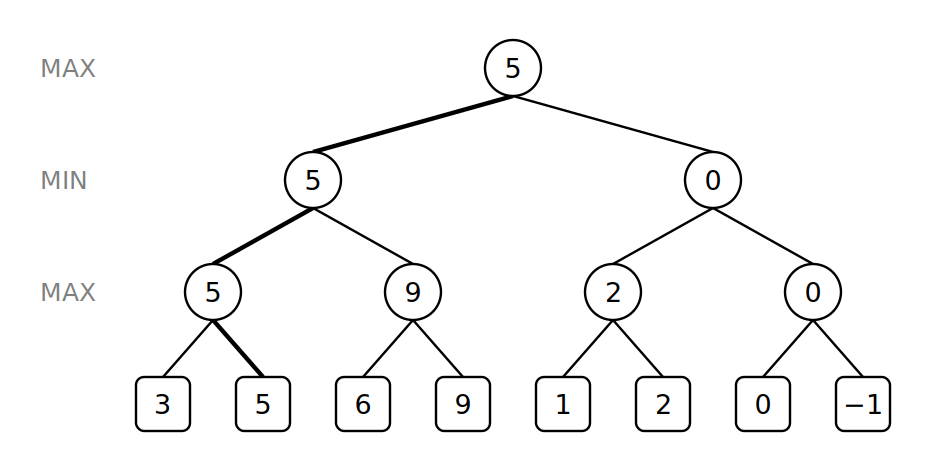
Пространство поиска здесь – дерево игры: узлы соответствуют позициям, рёбра – ходам, листья – терминальным позициям, в которых партия закончена. Уровни дерева чередуются: на одном ходит MAX, на следующем – MIN (рисунок 38). Собственную оценку имеют только листья, внутренние узлы получают её снизу вверх: MAX-узел берёт максимум оценок потомков, MIN-узел – минимум. В корне остаётся выбрать ход, ведущий в потомка с наибольшей оценкой.
Для крестиков-ноликов правила оценки терминальных позиций элементарны: выигрыш X – это , выигрыш O – это , ничья – 0. Пусть X – это MAX.
def minimax(state, player):
    if state является терминальным:
        return оценка терминального состояния state
    if player == MAX:
        best = -∞
        for each move, допустимый в state:
            best = max(best, minimax(применить move к state, MIN))
    else:
        best = ∞
        for each move, допустимый в state:
            best = min(best, minimax(применить move к state, MAX))
    return best
Такой алгоритм играет безупречно, но среди одинаково оценённых вариантов не различает быстрых и медленных, из-за чего агент может «тянуть» с уже гарантированным выигрышем. Лечится это включением глубины в оценку терминала: выигрыш X оценивается как , выигрыш O – как . Тогда близкая победа ценится выше далёкой, скорое поражение хуже отсроченного, и агент дожимает выигранную партию, но максимально сопротивляется в проигранной.
Куда существеннее другое ограничение: перебор до листьев возможен только на очень малых играх. Дерево крестиков-ноликов от пустой доски обозримо, дерево шахмат – нет. Стандартное решение – ограничить глубину и оценивать нетерминальные позиции эвристически. Для тех же крестиков-ноликов подойдёт, например, разность между числом строк, столбцов и диагоналей, целиком свободных для X, и тем же числом для O, а выигрышные позиции оцениваются как и . Ещё один общий приём сокращения перебора – учёт симметрии: симметричные позиции по сути идентичны, поэтому разворачивать их повторно не нужно. Известный пример шахматного движка на основе минимакса – Stockfish.
Альфа-бета отсечения (Alpha-Beta Pruning) – приём оптимизации минимакса, позволяющий не раскрывать ветви, заведомо не влияющие на результат. Алгоритм несёт по дереву две границы:
- – наибольшее значение, которое MAX уже гарантировал себе выше по дереву;
- – наименьшее значение, которое MIN уже гарантировал себе выше по дереву.
По мере рассмотрения новых потомков у MAX-вершин может только расти, а у MIN-вершин – только убывать. Как только оказывается, что , дальнейший перебор потомков текущей вершины бессмыслен: одна из сторон уже располагает выше по дереву вариантом не хуже, и в это поддерево игра просто не придёт. Оставшиеся ветви отсекаются, т.е. даже не раскрываются (рисунок 39).
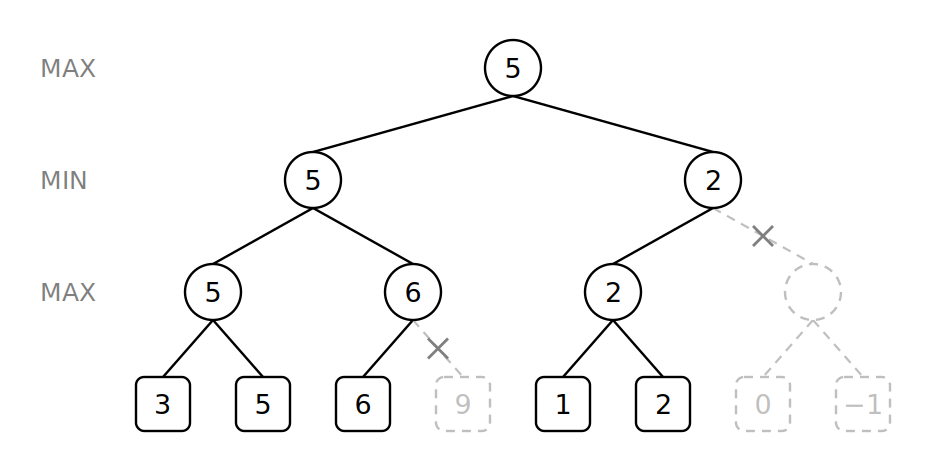
В приведённом выше псевдокоде это всего две дополнительные строки в каждой ветви: после возврата из очередного потомка обновляется соответствующая граница ( у MAX-вершины, у MIN-вершины), и при цикл по оставшимся ходам прерывается.
Принципиально, что отсечения не меняют результат: возвращается ровно та же оценка и тот же ход, что и при полном переборе, экономится только работа. По духу приём очень близок методу ветвей и границ из главы о дискретной оптимизации: там точно так же отбрасываются подзадачи, граница оценки которых не может побить уже найденное решение.
Эффективность отсечений сильно зависит от порядка перебора ходов: чем раньше рассмотрен сильный ход, тем раньше сузятся границы и тем больше ветвей отпадёт. При идеальном порядке эффективная ветвистость снижается примерно с до , что при том же бюджете времени позволяет заглянуть вдвое глубже. Поэтому на практике ходы предварительно упорядочивают эвристиками.
Даже с отсечениями ветвистость и глубина дерева могут не позволить решить задачу за приемлемое время. Тогда масштаб поиска ограничивают дополнительно:
- задают предельную глубину и оценивают позиции на ней эвристикой;
- не разворачивают заведомо неперспективные ветви, ориентируясь на эвристики (в отличие от альфа-бета такое отсечение уже может стоить точности);
- сохраняют базу оценённых состояний, чтобы не пересчитывать позицию, встретившуюся повторно другим порядком ходов;
- в играх с понятным конечным выигрышным состоянием применяют обратный поиск – от цели к текущей позиции.
Саму эвристическую оценку позиции не обязательно составлять вручную: её роль может играть обученная ML-модель, например, нейросеть. Обучать такую модель можно, прогоняя огромное количество симуляций игры бота с самим собой.
Monte Carlo Tree Search (MCTS) – альтернатива минимаксу, основанная на случайном сэмплировании. Метод не требует оценочной функции и не перебирает дерево целиком: дерево строится выборочно, позиции оцениваются статистикой случайных доигрываний, а бюджет итераций сам стягивается к перспективным ветвям. Именно поэтому MCTS стал основным подходом там, где ветвление огромно, а оценку позиции написать трудно (например, игра в го).
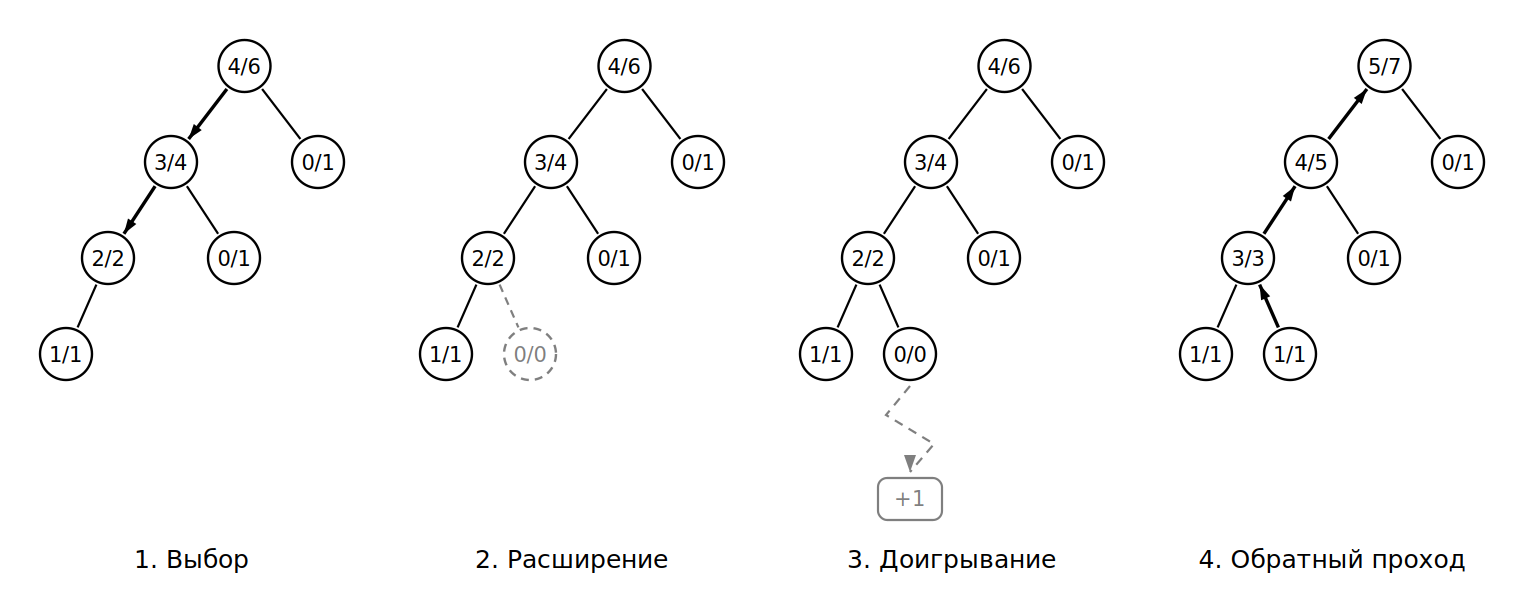
Каждая итерация состоит из четырёх фаз (рисунок 40):
- Selection (выбор пути вниз) – спускаемся от корня по уже построенному дереву, выбирая на каждом шаге наиболее перспективного потомка, пока не дойдём до узла с нераскрытыми ходами;
- Expansion (расширение дерева) – добавляем к этому узлу нового потомка, соответствующего ещё не испробованному ходу;
- Simulation (случайная партия, rollout) – из нового узла доигрываем партию до конца, выбирая ходы случайно или по простой эвристике; получаем один исход: выигрыш, проигрыш или ничью;
- Backpropagation (обратное распространение) – протаскиваем исход вверх по пройденному пути до корня, увеличивая у каждого узла счётчик посещений и накопленную награду.
Ключевой вопрос – как выбирать потомка в фазе выбора. Спускаться жадно, туда, где выше доля побед, рискованно: перспективная ветвь, которой не повезло в первых доигрываниях, будет брошена слишком рано. Поэтому эксплуатацию уже хороших ветвей балансируют с исследованием редко посещавшихся по формуле UCT (Upper Confidence bound applied to Trees):
Здесь – накопленная награда за партии через потомка , – число его посещений, – число посещений родителя, – коэффициент исследования. Первое слагаемое тянет в уже хорошие ветви, второе растёт у давно не посещавшихся и обращается в бесконечность у ни разу не испробованных, поэтому такие пробуются в первую очередь.
def mcts(root, budget):
    for k = 0; k < budget; k++:
        node = root
        # 1. Selection: спуск по уже построенному дереву
        while node не терминален and все ходы из node уже раскрыты:
            node = потомок node с наибольшим UCT
        # 2. Expansion: добавление одного нового потомка
        if node не терминален:
            node = добавить к node потомка по неиспробованному ходу
        # 3. Simulation: случайное доигрывание до конца партии
        result = доиграть партию из node случайными ходами
        # 4. Backpropagation: протаскивание исхода вверх до корня
        while node != None:
            node.visits++
            node.reward += result с точки зрения игрока, ходящего в node
            node = node.parent
    return потомок root с наибольшим числом посещений
Итоговым ходом берут, как правило, не потомка корня с наибольшей долей побед, а наиболее посещаемого. Число посещений устойчивее к шуму случайных доигрываний.
У MCTS есть три ценных практических свойства. Во-первых, метод вообще не требует оценочной функции. Во-вторых, его можно прервать на любой итерации: качество ответа растёт с их числом, но осмысленный ответ есть уже после первых, что удобно при жёстком бюджете на кадр. В-третьих, в отличие от минимакса он хорошо распараллеливается, т.к. независимые доигрывания можно вести одновременно. Плата – приближённость результата: он зависит от случайных доигрываний и от выделенного бюджета. Впрочем, в сильнейших движках случайное доигрывание давно вытеснено более надёжной оценкой: у AlphaZero и Leela Chess Zero её даёт обученная нейросеть, у Komodo в режиме MCTS – короткий альфа-бета поиск. От метода при этом остаётся главное: выборочное построение дерева, баланс по UCT и выбор хода по статистике посещений. Из игр MCTS применялся, например, в Total War: Rome II.
Goal Oriented Action Planning (GOAP) – подход, при котором поведение агента не задаётся заранее, а синтезируется. Разработчик описывает не «что делать в такой-то ситуации», а лишь набор доступных агенту действий и его цели. Последовательность шагов, ведущую к цели, агент выстраивает сам.
Знания агента о мире представляются фактами-предикатами (Predicates), а совокупность актуальных фактов образует состояние (State). Каждое действие (Action) задаётся:
- предусловиями (Preconditions) – набором фактов, которые должны быть истинны, чтобы действие было применимо;
- эффектами (Effects) – изменениями состояния при выполнении действия, т.е. добавлением и снятием фактов;
- стоимостью, отражающей относительную предпочтительность действия.
Небольшой набор действий бойца приведён в таблице 7.
Таблица 7. Пример описания действий в GOAP
| Действие | Предусловия | Эффекты | Стоимость |
|---|---|---|---|
| Подойти к ящику | – | у ящика | 2 |
| Взять патроны | у ящика | есть патроны | 1 |
| Перезарядить | есть патроны | оружие заряжено | 1 |
| Занять укрытие | укрытие известно | в укрытии | 2 |
| Атаковать | оружие заряжено, враг видим | враг убит | 3 |
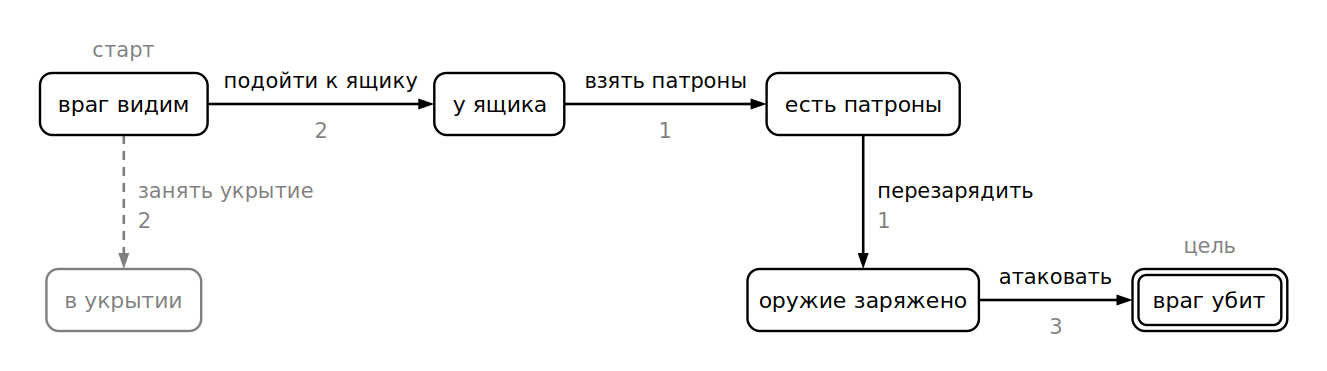
Помимо действий у каждого персонажа заданы цели (Goals) – желаемые состояния мира. Цели могут иметь приоритеты и меняться динамически. Состояния, связанные применимыми действиями, образуют граф, начальная вершина которого – текущее состояние мира, а целевая – любое состояние, удовлетворяющее цели. Значит, построение плана есть не что иное, как поиск пути в графе состояний, а стоимости действий играют роль весов рёбер (рисунок 41). Классическая реализация использует A*, причём поиск обычно ведут в обратном направлении, от цели к текущему состоянию. Целей у агента немного, а достижимых состояний мира огромное количество. Для состояния «враг видим, укрытие известно» и цели «враг убит» по таблице 7 получится план из четырёх действий общей стоимостью 7: подойти к ящику, взять патроны, перезарядить, атаковать.
Найденный план исполняется по шагам. Для исполнения достаточно небольшого конечного автомата. В F.E.A.R., где GOAP был впервые применён, он состоял всего из трёх состояний: движение к точке, взаимодействие с объектом и воспроизведение анимации. Всё разнообразие поведения обеспечивал планировщик, а не автомат.
Мир при этом меняется, и построенный план может устареть. Практикуются три уровня проверок:
- при первичном построении плана создаётся копия мира, на которой прогоняется симуляция выполнения плана для подтверждения его валидности;
- для цели может быть задана функция, постоянно проверяющая, не пора ли отказаться от текущего плана и переключиться на другой (цель «убить игрока» может смениться при ранении);
- каждое действие проверяется непосредственно перед выполнением, и при провале проверки вызывается перепланирование.
Главное достоинство GOAP – комбинаторное богатство поведения при скромном описании. В F.E.A.R. насчитывалось порядка 120 действий и около 70 целей, а наблюдаемая тактика противников складывалась из их сочетаний, а не прописывалась явно. Оборотная сторона – стоимость планирования в реальном времени и заметно большая сложность отладки. Если BT можно просмотреть глазами, то ответ на вопрос «почему агент поступил именно так» приходится восстанавливать по цепочке предусловий и эффектов. Примеры использования: F.E.A.R., Condemned: Criminal Origins, S.T.A.L.K.E.R.: Shadow of Chernobyl, Just Cause 2, Deus Ex: Human Revolution, Tomb Raider (2013), Middle-Earth: Shadow of Mordor.
Близкий по духу подход – иерархические сети задач (Hierarchical Task Network, HTN). В них планирование идёт не от фактов, а сверху вниз: составная задача рекурсивно раскладывается на подзадачи по заготовленным методам, пока не останутся элементарные действия. HTN применялся в Killzone 2, Max Payne 3, Dying Light, Horizon Zero Dawn.
11.4. Знания и обучение
Любая из рассмотренных моделей принимает решения, опираясь на знания агента о мире. От того, как эти знания представлены, зависит и сложность логики, и её производительность. Удачное представление сводит дорогую проверку к чтению одного числа.
Простейший приём – разметка объектов тегами («укрытие», «дверь», «источник шума»). Логика тогда оперирует категориями, а не конкретными объектами: агенту незачем знать, что именно перед ним, достаточно факта наличия поблизости объекта с нужным тегом. Пространственные знания обычно хранятся в навигационной сетке (NavMesh) – разбиении проходимой части уровня на выпуклые полигоны, по графу которых и ведётся поиск пути. Наконец, знания полезно забывать: фактам назначают время жизни (timeout) или постепенно затухающую достоверность (decay). Потерявший игрока из виду противник не должен знать его позицию вечно – это и правдоподобнее, и ограничивает объём памяти агента.
Blackboard («доска объявлений») – централизованное хранилище «ключ-значение» (например, TargetEnemy: ID_42), отделяющее данные от логики поведения. Именно благодаря ему дерево поведения остаётся статичным и общим для всех агентов: изменяемое состояние лежит не в дереве, а на доске. Вторая роль blackboard – канал обмена. Через него общаются узлы дерева, сенсоры и прочие подсистемы ИИ, а через общую доску отряда – и агенты между собой. Область видимости доски выбирается по смыслу данных: локальная для узла (временный расчёт пути), уровня дерева (состояние миссии), уровня агента (здоровье, инвентарь) либо глобальная (координаты союзников). Blackboard есть в Unreal Engine и Unity.
Карты влияния (Influence Maps) – структура для пространственных рассуждений. Уровень разбивается на ячейки, с каждой из которых связано число – «влияние». Источниками служат юниты, здания, угрозы, а влияние распространяется от источника по соседним ячейкам с затуханием:
где – расстояние от источника до ячейки , а задаёт скорость затухания. Применяются и другие схемы распространения: гауссово размытие либо flooding, когда ячейка получает максимум из значений соседей.
Готовая карта дёшево отвечает на вопросы, дорогие при прямом переборе объектов: какая территория контролируется, где проходит линия фронта (там, где влияния сторон уравновешиваются), куда идти опасно, куда безопасно отступать. Считается она один раз на всех агентов и не требует пересчёта, пока сущности не двигаются. Карты разного смысла (угроза, видимость, доступность ресурсов) накладываются друг на друга, давая комбинированные оценки. Ценно и то, что карта тривиально визуализируется, а значит, легко отлаживается. Основная область применения – стратегии и тактические игры: StarCraft II, Company of Heroes 2, Age of Empires II, Homeworld 3, Killzone.
Обучение в играх применяется редко, т.к. агент, меняющий поведение уже в процессе игры, плохо тестируется и способен сломать баланс. Поэтому модели обычно обучают заранее, а в игре используют уже обученными, ограничиваясь простыми и предсказуемыми методами:
- цепи Маркова и n-граммы – предсказание следующего действия игрока по нескольким предыдущим; классический пример – запоминание излюбленных комбинаций игрока в файтингах;
- наивный байесовский классификатор – оценка вероятности гипотезы о намерениях игрока по набору наблюдаемых признаков;
- алгоритмы построения деревьев решений (ID3 и родственные) – автоматический синтез по размеченным примерам уже упоминавшейся ранее структуры;
- нейронные сети – например, Drivatar в серии Forza: модель обучается на заездах конкретного игрока и затем водит в его манере вместо него.
Отдельно стоит обучение с подкреплением, наиболее известный представитель которого – Q-learning. Агент хранит таблицу – оценку суммарной будущей награды за действие в состоянии . Выполнив действие, получив награду и оказавшись в состоянии , он корректирует оценку:
где – скорость обучения, а – коэффициент, задающий, насколько ценится отдалённая награда по сравнению с немедленной. Табличное представление применимо, лишь пока состояний и действий немного. При большом или непрерывном пространстве состояний его либо квантуют, разбивая на бакеты, либо заменяют таблицу аппроксимирующей функцией (чаще всего нейросетью).
11.5. Роевое поведение и перемещение
Массовку (стаю птиц, косяк рыб, толпу, рой насекомых) невозможно программировать поштучно. Вместо этого всем участникам задают одни и те же простые правила, учитывающие лишь ближайших соседей, а сложное коллективное поведение возникает само (это явление называют эмерджентностью). Централизованного управления нет вовсе, поэтому модель естественно масштабируется на тысячи агентов.
Каноническая модель – Boids Крейга Рейнольдса. Каждый агент подчиняется трём правилам, вычисляемым по его локальной окрестности:
- разделение (Separation) – не приближаться к соседям ближе заданного расстояния;
- выравнивание (Alignment) – стремиться к среднему вектору скорости соседей;
- сплочённость (Cohesion) – стремиться к центру масс окрестности.
Каждое правило даёт вектор ускорения, а итоговый получается их взвешенной суммой. Меняя веса, получают что угодно от плотного косяка до разреженной стаи. На практике к трём базовым правилам добавляют уклонение от препятствий и притяжение к цели. В кино Boids появились раньше, чем в играх (например, стаи летучих мышей и пингвинов в «Бэтмен возвращается», 1992), а из игр их применяли Half-Life, Left 4 Dead, Hitman: Absolution, Assassin's Creed Unity, Days Gone.
Узкое место реализации – поиск соседей. Наивно это на каждый кадр. Поэтому используются пространственные индексы на структурах, о которых будет идти речь в главе 12.
Родственные модели: самодвижущиеся частицы (Self-Propelled Particles, модель Вичека) оставляют из трёх правил только выравнивание, добавляя случайный шум; системы частиц – вырожденный случай, в котором частицы вообще не взаимодействуют друг с другом (дым, искры, брызги). Другой возможный принцип коллективного поведения – общение не напрямую, а через изменения среды. Классический пример – муравьиные алгоритмы, которые могут быть реализованы не только как оптимизационная метаэвристика, но и как имитационная модель.
Три правила Boids – частный случай более общей идеи того же автора, steering behaviors. Агент, всегда смотрящий в сторону цели и перемещающийся к ней по прямой, выглядит неестественно. Пусть заданы элементарные поведения: seek (двигаться к точке), flee (уходить от неё), arrive (подъезжать с замедлением), pursue (идти на упреждение), wander (бесцельно бродить), obstacle avoidance (обходить препятствия), path following (держаться маршрута). Каждое возвращает вектор ускорения; эти векторы складываются, а сумма ограничивается предельными ускорением и скоростью агента. Плавность получается сама собой, из инерции и этих ограничений, а сложное движение набирается из готовых слагаемых.
Отдельная проблема – массовое перемещение в стратегиях. Сотня юнитов, отправленных в одну точку, означает сотню поисков пути за кадр. Решение – поля потока (Flow Fields): от цели один раз проводится волна по всей карте (по сути поиск в ширину или алгоритм Дейкстры), и в каждой ячейке запоминается направление к цели. Дальше юниты путь не ищут вовсе, а читают готовое направление из своей ячейки, поэтому стоимость перестаёт зависеть от их числа. Со столкновениями между самими юнитами разбирается уже steering-слой.
11.6. Процедурная генерация
Процедурная генерация – построение игрового контента алгоритмом вместо ручной работы. К ней прибегают ради объёма (миры, которые невозможно сделать руками), разнообразия и реиграбельности (каждый забег в roguelike проходит по новой карте), экономии труда и места.
Шумы. Функция шума сопоставляет точке пространства псевдослучайное значение: . Принципиально, что это именно функция: её значение зависит только от координат и от зерна (seed) генератора, поэтому любую точку можно вычислить в любой момент, независимо от всех остальных и ничего не храня. На этом стоят бесконечные миры: в Minecraft мир не существует заранее, очередной его кусок порождается по координатам и зерну в тот момент, когда игрок до него доходит. А чтобы получить в точности тот же мир, достаточно передать другому игроку одно число.
Размерность выбирают по задаче: 1D – звук и колебания, 2D – карты и текстуры, 3D – объёмные структуры вроде облаков и пещер, 4D – анимация объёма без скачков. Основные виды:
- Белый шум – независимые значения в каждой точке, все частоты представлены одинаково. Синий шум – шум с подавленными низкими частотами: выборка точек по нему ложится равномерно, без сгустков и пустот, что и нужно при размещении объектов, декалей и точек спавна.
- Градиентные, или гладкие, шумы (шум Перлина, Simplex и OpenSimplex) – значения соседних точек близки, что даёт естественный рельеф, облака, волны, границы биомов. Складывая несколько октав (копий шума с растущей частотой и убывающей амплитудой), получают одновременно и крупные формы, и мелкие детали.
- Шум Вороного (Worley, клеточный) – расстояние до ближайшей случайной точки-семени. Даёт ячеистые структуры: трещины, чешую, камень, кожу.
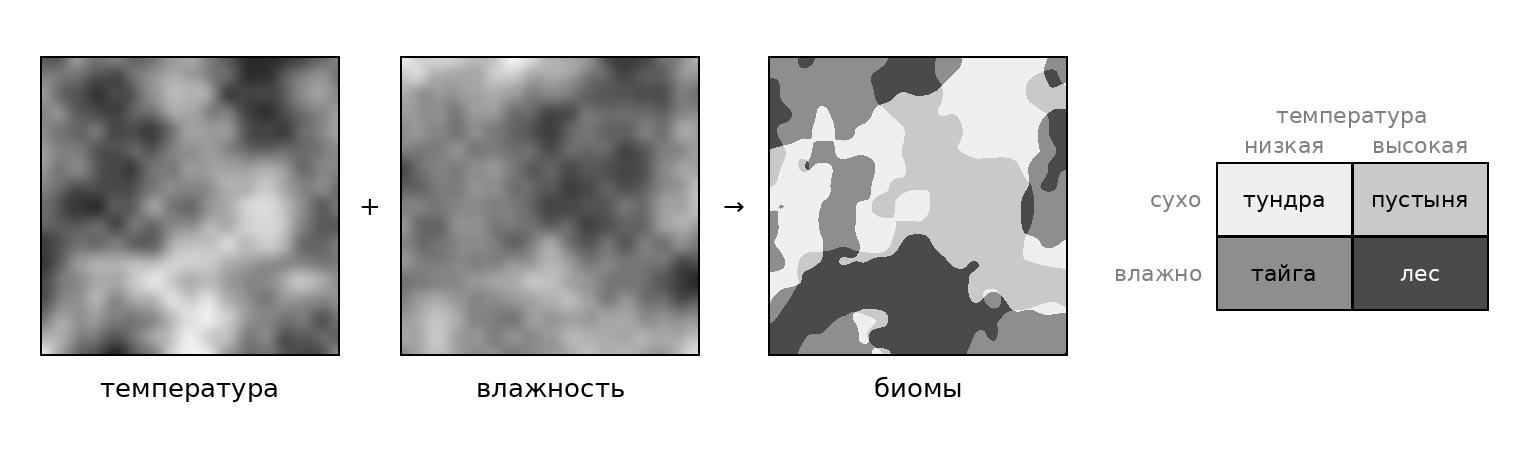
Сам по себе шум даёт лишь поле чисел, смысл ему придаёт интерпретация. Типовой приём – собрать результат из нескольких независимых слоёв. Так, биом в Minecraft выбирается не по одному значению, а по сочетанию климатических параметров. В упрощённом виде достаточно двух – температуры и влажности (рисунок 42). Каждый параметр задаётся своим шумом со своим зерном, а тип биома в точке определяется тем, в какую клетку таблицы попала пара значений. Плавность шума даёт при этом плавность результата: соседние точки почти всегда попадают в один и тот же биом, поэтому биомы получаются связными областями с извилистыми границами, а не рассыпаются в кашу.
Клеточные автоматы. Поле разбито на клетки, каждая из которых находится в одном из конечного числа состояний. Все клетки обновляются одновременно в дискретные моменты времени по одному и тому же правилу, не зависящему ни от времени, ни от положения клетки, а зависящему только от состояний соседей. Несмотря на предельную простоту определения, автоматы дают богатое поведение (самый известный пример – игра «Жизнь» Конвея). В генерации ими сглаживают случайно зашумлённое поле: правило «если вокруг много стен, стань стеной» за несколько итераций превращает белый шум в правдоподобные пещеры. Ими же симулируют среду – распространение огня («если клетка горит, а сосед – дерево, сосед загорается»), течение воды, дым и газ, разрушения, а также простейшее поведение толпы. Дальше всех эту идею довела Noita, где на клеточном автомате построена вся физика мира: каждый пиксель – клетка со своим материалом, песок сыплется, жидкости текут и смешиваются, газы поднимаются, а огонь распространяется по всему горючему.
Wave Function Collapse (WFC) – алгоритм сборки карты из набора тайлов с заданными правилами соседства. Название вдохновлено квантовой механикой. Изначально каждая клетка находится в «суперпозиции»: ей допустим любой тайл. На каждом шаге выбирается клетка с наименьшей неопределённостью, т.е. с наименьшим числом допустимых вариантов, для неё случайно выбирается тайл, после чего ограничения распространяются на соседей. Если у какой-то клетки допустимых вариантов не осталось, выполняется откат либо, как в исходной реализации, перезапуск генерации с нуля. По сути это распространение ограничений – тот же приём, что и в решателях судоку. Отдельная ценность WFC в том, что правила соседства не обязательно задавать вручную: их можно извлекать из нарисованного художником образца или существующего уровня и генерировать похожее. Примеры использования: Bad North, Townscaper, The Unexpected Quest.
Прочие распространённые техники:
- диаграммы Вороного – разбиение территории на биомы, регионы, кварталы, участки суши;
- генерация лабиринтов остовными деревьями (случайный обход в глубину, алгоритм Прима) и алгоритмом Эллера, который строит лабиринт построчно и потому не требует держать его в памяти целиком;
- рекурсивное разбиение пространства (BSP) – деление прямоугольника на непересекающиеся комнаты с последующим соединением их коридорами, классика roguelike;
- алгоритмы туннелирования и случайное блуждание (Drunkard's Walk) – прокладка извилистых органичных ходов;
- системы на основе грамматик, в том числе L-системы – генерация растений, зданий, городов, а также квестов, диалогов и сюжетов.
Тем свойством шума, что любую точку можно вычислить независимо от прочих, остальные техники не обладают: клеточный автомат, WFC, разбиение BSP или случайное блуждание строят карту пошагово, и узнать, что окажется в конкретной точке, можно, только построив всё остальное. Воспроизводимость им обеспечивают иначе: вся случайность берётся из генератора псевдослучайных чисел, инициализированного зерном, и тогда одно и то же зерно при одном и том же порядке шагов даёт один и тот же результат.
На практике генерацию редко пускают на самотёк. Обычно её комбинируют с ручной работой: алгоритм собирает уровень из подготовленных вручную блоков либо создаёт заготовку, которую затем дорабатывает дизайнер. Кроме того, результат необходимо проверять: сгенерированная карта должна быть проходимой и интересной, поэтому генератор дополняют критериями качества и перезапускают, если результат неудовлетворителен.