7. Методы разработки алгоритмов
7.1. Общая информация
Разработка алгоритма решения любой сложной вычислительной задачи – трудоёмкий творческий процесс. Однако для некоторых классов задач возможны общие подходы, определяющие логику построения алгоритма. В этой и некоторых следующих главах рассматривается ряд подобных методов. Среди них:
- метод грубой силы (brute force, полный перебор);
- метод декомпозиции (decomposition, «разделяй и властвуй»);
- метод уменьшения размера задачи («уменьшай и властвуй»);
- жадные алгоритмы (greedy algorithms);
- динамическое программирование (dynamic programming);
- метод преобразования задачи («преобразуй и властвуй»);
- методы поиска в пространстве состояний, в том числе:
- поиск с возвратом (backtracking);
- локальный поиск (local search).
Универсального и эффективного метода, который бы позволял решать любые задачи, не существует. Часто для решения одной и той же задачи можно использовать несколько подходов, получив алгоритмы, обладающие различными свойствами, достоинствами, недостатками.
7.2. Метод грубой силы
Метод грубой силы (brute force) предполагает поиск решения «в лоб», т.е. без введения каких-то дополнительных построений и лишних концепций. Он оперирует только тем, что дано в условии задачи и известно из определений задействованных понятий.
Некоторые примеры такого подхода:
- нужно найти произведение матриц – вычисляем каждый элемент как сумму произведений строки на столбец, прямо по определению;
- нужно найти элемент в структуре данных – обойдём и проверим каждый (линейный поиск);
- нужно упорядочить элементы от самого меньшего до самого большего – будем отбирать их по одному (сортировка выбором).
Особенно часто данный метод упоминается в контексте решения комбинаторных задач. Т.е. таких задач, где среди множества неких объектов (или комбинаций) нужно найти тот, который удовлетворяет определённому условию. Прямолинейный подход в данном случае сводится к полному перебору. Частный случай применения метода – примитивный способ взлома паролей перебором комбинаций символов. Потому важно не использовать простые пароли.
Пусть дано облако точек на плоскости (географические координаты или набор объектов, характеризуемых двумя параметрами). Необходимо найти пару точек, расстояние между которыми минимально. Алгоритм решения методом грубой силы со сложностью :
def closest_pair(points):
    n = len(points)
    min_dist = ∞
    min_pair = None
    for i = 0; i < n; i++:
        for j = i + 1; j < n; j++:
            dist = ((points[i][0] - points[j][0]) ** 2 + (points[i][1] - points[j][1]) ** 2) ** 0.5
            if dist < min_dist:
                min_dist = dist
                min_pair = (points[i], points[j])
    return min_pair
Достоинство подхода в простоте и широкой применимости. Недостаток – низкая эффективность. Для простых задач или малых размеров данных может быть вполне уместен.
7.3. Метод декомпозиции
Метод декомпозиции («разделяй и властвуй») предполагает разбиение исходной задачи на подзадачи, которые решаются отдельно, а затем результаты объединяются в ответ на исходную задачу.
Основные шаги метода:
- экземпляр задачи разбивается на несколько меньших экземпляров той же задачи, в идеале – одинакового размера;
- решаются меньшие экземпляры задачи (обычно рекурсивно);
- при необходимости решение исходной задачи находится путём комбинации решений меньших экземпляров.
Ранее мы уже рассматривали многие алгоритмы, соответствующие методу декомпозиции: сортировка слиянием, быстрая сортировка, обход бинарного дерева и т.д. Кроме того, для анализа временной сложности подобных алгоритмов применима мастер-теорема, о которой говорилось в разделе анализа алгоритмов.
Для наглядности приведём алгоритм суммирования, соответствующий подходу декомпозиции:
def array_sum(array, left, right):
    if left > right:
        # Вырожденный случай: пустой участок
        return 0
    if left == right:
        # Базовый случай: участок из одного элемента
        return array[left]
    middle = (left + right) // 2
    # Две независимые подзадачи вдвое меньшего размера
    left_sum = array_sum(array, left, middle)
    right_sum = array_sum(array, middle + 1, right)
    return left_sum + right_sum # Комбинирование решений подзадач
По сравнению с грубой силой (линейный проход с накоплением суммы в переменной-аккумуляторе) такая версия прямого выигрыша не даёт. Хотя многие алгоритмы, получаемые методом декомпозиции, оказываются гораздо эффективнее прямолинейных подходов. Но даже при отсутствии выигрыша во временной сложности, важным преимуществом становится распараллеливаемость таких версий. Ведь решение независимых подзадач можно производить на разных решателях (ядрах, процессорах, серверах) параллельно.
При решении подзадач рекурсивно стоит помнить о риске переполнения стека. Начиная с некоторой глубины рекурсии, подзадачу можно решать другим алгоритмом, более подходящим для малых размеров. Например, в библиотечных реализациях сортировки слиянием на малом размере подпоследовательности вызывается сортировка вставками. Хотя в данном примере это больше обусловлено вопросами эффективности.
Если при применении метода декомпозиции выделяется всего одна задача меньшего размера, то такой подход называют методом уменьшения размера задачи («уменьшай и властвуй»). Однако в силу специфики его правомерно рассматривать как самостоятельный метод, а не просто как частный случай декомпозиции. Например, к таким алгоритмам неприменима мастер-теорема, отсутствуют фаза комбинирования, параллелизм и т.д. Примеры алгоритмов: бинарный поиск, сортировка вставками.
7.4. Жадные алгоритмы
Жадные алгоритмы – это обширный спектр методов, которые объединяет единый подход:
- решение задачи разбивается на последовательность шагов;
- на каждом шаге принимается локально оптимальное решение (т.е. кажущееся наиболее выгодным в данный момент);
- предполагается, что полученный после осуществления всех шагов результат будет хотя бы приближённо оптимален в глобальном смысле.
Логика жадного подхода не всегда позволяет получать точные или оптимальные решения. Ведь для оптимального результата может потребоваться совершить локально невыгодные действия. Алгоритм же не видит всей картины, он мыслит отдельными шагами. Среди уже известных нам точных жадных алгоритмов: алгоритмы Крускала, Прима, Дейкстры. Пример приближённого – жадный поиск по первому наилучшему совпадению.
Более наглядно рассмотрим этот подход на примере задачи о размене. Она формулируется следующим образом: имеется неограниченное количество монет номиналами . Требуется выдать сумму наименьшим числом монет. Пусть сумма рубля, а монеты бывают номиналов 1, 5 и 7 рублей. Для того чтобы минимизировать общее число монет, будем рассматривать номиналы в порядке убывания величины. На каждом шаге будем набирать столько монет текущего рассматриваемого номинала, сколько умещается. Получим такую последовательность шагов:
- номинал 7: можно взять максимум 3 монеты, что составляет 21, значит, остаётся набрать 3;
- номинал 5: нельзя взять ни одной монеты, т.к. 5 > 3;
- номинал 1: можно взять максимум 3 монеты и сумма полностью набрана.
Описанная логика прямолинейно переносится в код:
def greedy_change(coins, S):
    # coins – номиналы, упорядоченные по убыванию
    result = []
    for coin in coins:
        count = S // coin # Сколько монет номинала умещается в остатке
        for k = 0; k < count; k++:
            result.append(coin)
        S -= count * coin
        if S == 0:
            break
    if S > 0:
        # Данным набором номиналов сумма точно не набирается
        return None
    return result
Ответ, полученный таким способом – 6 монет. Однако оптимальное решение – 4 (две монеты по 7 и две монеты по 5). Это демонстрирует отсутствие гарантии оптимальности. Однако на фоне всех возможных комбинаций полученная достаточно хороша. Главное же преимущество подобных жадных алгоритмов – их скорость. Они активно применяются там, где допустимо пожертвовать гарантиями точности/оптимальности в угоду производительности.
Стоит отметить, что жадный размен ошибается не всегда. Наборы номиналов, на которых он гарантированно даёт оптимальный ответ, называют каноническими системами номиналов. К ним относятся, в частности, реальные денежные системы вида 1, 2, 5, 10, 50, 100 и т.д. Поэтому кассир, отсчитывающий сдачу от крупного номинала к мелкому, всегда выдаёт минимально возможное число монет и купюр.
Жадные алгоритмы тесно пересекаются с другим известным нам классом – эвристическими алгоритмами, т.к. локально оптимальный выбор часто базируется на эвристике (оценке или правиле). К таковым, например, можно отнести A* и жадный поиск по первому наилучшему совпадению. Однако относительно термина «эвристический» существует двойственность толкования: во многих источниках под этим подразумевают в целом алгоритмы, не гарантирующие точность решения. Тогда правомерно отнести жадный алгоритм решения задачи о размене к эвристическим (за исключением применения канонических систем номиналов). Хотя по другой трактовке он таковым не является, ведь базируется не на эвристической оценке. Поэтому нужно быть аккуратными при использовании данной терминологии.
7.5. Динамическое программирование
Динамическое программирование (далее ДП) – это метод решения задач путём разбиения на перекрывающиеся подзадачи с сохранением результатов их решения, чтобы не пересчитывать одно и то же многократно. Ключевым словом в этом определении является «перекрывающиеся». В методе декомпозиции подзадачи независимы. Например, в сортировке слиянием каждый элемент попадает ровно в одну ветку дерева рекурсии. При динамическом же программировании одна и та же подзадача встречается многократно, поэтому её решение можно вычислить единожды и переиспользовать.
Второе необходимое условие применимости ДП – оптимальная подструктура, известная также как принцип оптимальности Беллмана: оптимальное решение задачи должно составляться из оптимальных решений её подзадач. Иными словами, если некоторое частичное решение входит в оптимальное решение целого, то оно обязано быть оптимальным и для своей подзадачи. Выполняется оптимальная подструктура далеко не всегда. Например, задача о кратчайшем пути в графе ею обладает: любой участок кратчайшего пути сам является кратчайшим путём между своими концами. А вот задача о длиннейшем простом пути – нет: склейка двух длиннейших участков может дать путь, проходящий через вершину дважды, т.е. вообще не являющийся простым. Поэтому, прежде чем строить динамику, стоит убедиться, что задача обладает обоими свойствами: перекрытием подзадач и оптимальной подструктурой.
Простейший пример пригодной задачи – вычисление чисел последовательности Фибоначчи. Обозначим функцию вычисления n-го числа . Тогда , , а произвольный элемент последовательности определяется по формуле:
Заметим, что результат более сложной задачи (вычисление более дальнего числа последовательности) зависит от результатов более простых (более ранних чисел). Для вычисления нужен результат и , но для вычисления в свою очередь тоже понадобится результат и т.д. В наивной рекурсивной реализации это привело бы к многократным пересчётам одного и того же.
Существуют два подхода к реализации концепции ДП:
- Подход сверху вниз (мемоизация) – рекурсивная реализация с кешированием результатов (обычно в хеш-таблицу или массив). Т.е. необходимые решения подзадач сперва ищутся в кеше и пересчитываются только если их там ещё нет. Такой подход считает только реально нужные подзадачи, но создаёт накладные расходы на рекурсивные вызовы и стек.
- Подход снизу вверх (табуляция) – последовательное решение задач в направлении зависимости, т.е. от простых к более сложным, вплоть до необходимого экземпляра. Результаты заносятся в таблицу – многомерный (в общем случае) массив. При этом считаются все подзадачи в диапазоне (даже ненужные). Такая реализация нерекурсивна, поэтому отсутствует риск переполнения стека. Также эффективнее задействуется процессорный кеш. Кроме того, такая реализация позволяет сжатие размерности: если, например, зависит только от и , то незачем хранить все результаты, достаточно знать только константный набор предыдущих. Подобный приём позволяет радикально снизить сложность по памяти. Подход снизу вверх является более классическим, и большинство дальнейших примеров будут приводиться именно в соответствии с ним.
Проиллюстрируем на числах Фибоначчи. Реализация сверху вниз повторяет наивную рекурсию, но перед вычислением заглядывает в кеш, а после – пополняет его:
def fib_memo(n, memo):
    if n <= 1:
        return n # Базис динамики
    if n in memo:
        return memo[n] # Результат подзадачи уже получен ранее
    memo[n] = fib_memo(n - 1, memo) + fib_memo(n - 2, memo)
    return memo[n]
Реализация снизу вверх движется в обратном направлении – от базиса к нужному экземпляру. Здесь же наглядно применимо и упомянутое сжатие размерности:
def fib_table(n):
    if n <= 1:
        return n
    prev = 0; curr = 1 # Базис: fib(0) и fib(1)
    for i = 2; i <= n; i++:
        prev, curr = curr, prev + curr
    return curr
В общем случае для решения задачи методом ДП необходимо сформулировать следующее:
- Параметры, по которым будет строиться динамика. Часто это параметры, определяющие размеры экземпляра задачи. Для чисел Фибоначчи это был порядковый номер . В зависимости от числа параметров выделяют одномерную динамику, двумерную и т.д. Это же определяет размерность таблицы в методе снизу вверх.
- Рекуррентное соотношение, ставящее в зависимость решение более сложных (обычно более крупных) экземпляров задачи от решений более простых (обычно более мелких). Рекуррентное соотношение для чисел Фибоначчи указано в выражении (13).
- Базис динамики – вырожденные случаи задачи, в которых ответ очевиден и не требует решения. Часто это экземпляры, соответствующие граничным значениям параметров. и – базис динамики.
Зачастую наиболее удобно сперва задуматься о базисе динамики, т.е. подумать, в каких случаях рассматриваемой задачи ответ очевиден. Характеристики, отличающие эти случаи от остальных, подскажут параметры, по которым можно пробовать строить динамику. Определившись со всем перечисленным, применение метода происходит в три шага:
- инициализация (кеша или таблицы, заполнение базисных случаев);
- заполнение таблицы в соответствии с рекуррентным соотношением, двигаясь от базиса к требуемому размеру задачи (для табуляции), или рекурсивное решение с кешированием и переиспользованием результатов (для мемоизации);
- при необходимости – восстановление структуры (пути) решения.
Если удалось составить рекуррентное соотношение и выявить базисные случаи, то задача фактически решена. Программный код заполнения ячеек массива в соответствии с формулой прост и прямолинеен.
Рассмотрим пример. Задана последовательность целых чисел , необходимо найти возрастающую подпоследовательность наибольшей длины. Полный перебор потребовал бы рассмотрения комбинаций, что недопустимо для больших .
Обозначим – длина наибольшей возрастающей подпоследовательности, которая заканчивается в . Тогда (последовательность из одного числа априори является возрастающей) – базис динамики. Произвольное решение можно определить по рекуррентному соотношению:
Логика рекуррентного соотношения такова: очередное число (мы движемся в сторону увеличения ) добавляется последним к некоторой уже известной подпоследовательности. Чтобы не нарушилось необходимое свойство, предыдущее число должно быть меньше i-го (отсюда ). А также по условию задачи нас интересует наибольшая по длине последовательность, поэтому среди всех вариантов выбираем . Длина итоговой подпоследовательности с учётом добавленного i-го числа увеличилась на единицу. Длина искомой подпоследовательности – максимум по всему массиву ; восстановление начинается с ячейки, в которой этот максимум достигнут. Для определения подпоследовательности нужно двигаться в обратном направлении, восстанавливая, каковы были последние числа, к которым приписывалось очередное. Для упрощения восстановления структуры решения выгоднее при заполнении таблицы сразу помечать эту информацию (индексы предыдущих) в отдельном массиве .
Соответствующая реализация:
def lis(a):
    n = len(a)
    d = массив длины n, заполненный единицами
    prev = массив длины n, заполненный значением -1
    for i = 1; i < n; i++:
        for j = 0; j < i; j++:
            # a[i] можно приписать к подпоследовательности, кончающейся в a[j]
            if a[j] < a[i] and d[j] + 1 > d[i]:
                d[i] = d[j] + 1
                prev[i] = j
    # Ответ – максимум по всему массиву d
    best = 0
    for i = 1; i < n; i++:
        if d[i] > d[best]:
            best = i
    # Восстановление подпоследовательности, начиная с её конца
    result = []
    i = best
    while i != -1:
        result.append(a[i])
        i = prev[i]
    return result в обратном порядке
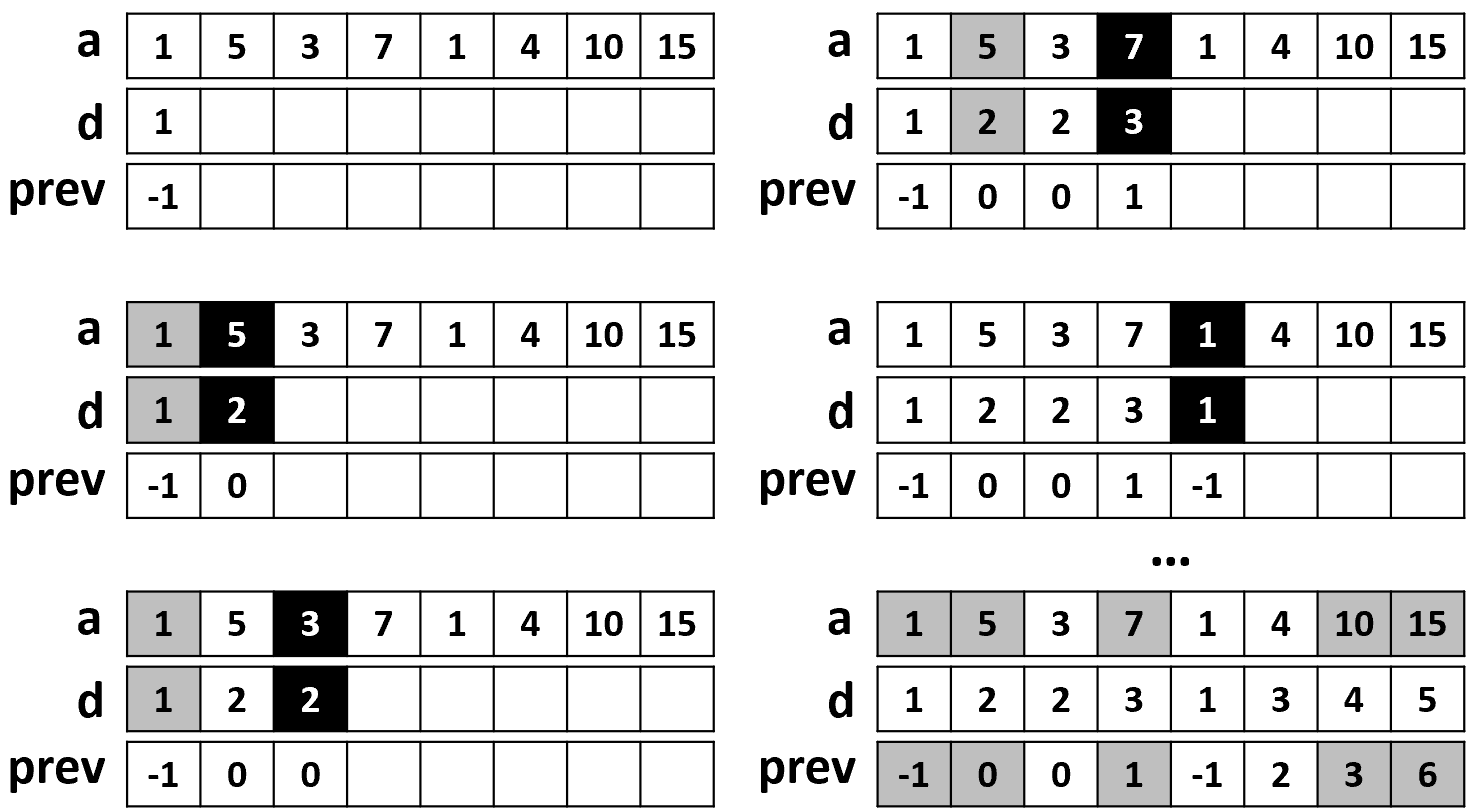
На рисунке 22 представлены некоторые шаги алгоритма для последовательности 1, 5, 3, 7, 1, 4, 10, 15.
Время работы такого алгоритма – . Существует улучшенная версия со сложностью : вместо массива длин поддерживается массив минимальных возможных последних элементов подпоследовательностей каждой длины, а место очередного числа в нём ищется бинарным поиском.
Рассмотренную ранее задачу о размене тоже можно решить с помощью ДП. Пусть – минимальное количество монет для размена суммы , – номиналы. Тогда:
Базис (16) объясняется тем, что чтобы выдать нулевую сумму, достаточно нуля монет. Смысл соотношения (15): рассмотрим все варианты, какая монета была добавлена последней, и возьмём минимум.
Двумерную динамику продемонстрируем на примере классической задачи о рюкзаке (ранце): имеется рюкзак вместимости и набор уникальных предметов. У каждого предмета есть размер и ценность . Необходимо уложить рюкзак так, чтобы добиться максимальной суммарной ценности положенных предметов, но не превысить вместимость.
Базисные случаи очевидны: в рюкзак нулевой вместимости ничего не поместится и класть в рюкзак нечего, если множество предметов пусто. Это подсказывает два параметра, по которым будем строить динамику. Пусть множество предметов линейно упорядочено, а – максимальная ценность, достижимая в рюкзаке вместимости при рассмотрении подмножества из первых предметов. Получим следующую постановку:
Приём введения параметра, который позволяет постепенно расширять множество рассматриваемых элементов, популярен в решении подобных задач. Добавление в поле нашего зрения очередного i-го предмета либо позволило найти более оптимальную комбинацию с его участием, либо ничего не изменило. Компонента – это максимальная ценность, достижимая без участия нового предмета (на множестве первых предметов). В комбинации же с участием нового предмета (компонента ) он уже занял собой в рюкзаке, тогда оставшееся за вычетом него место – . И нам уже известен вариант оптимальной укладки этого пространства на множестве первых предметов (i-й предмет не может быть положен повторно, поэтому , а не ). Функция агрегирования берёт лучшее из данных двух решений.
В коде рекуррентное соотношение превращается в два вложенных цикла по параметрам динамики. Размеры и ценности предметов лежат в массивах w и p с обычной индексацией от нуля, тогда как строки таблицы нумеруются от 0 до : строка отвечает первым предметам. Поэтому предмету, добавляемому на i-м шаге, соответствует индекс :
def knapsack(w, p, n, W):
    d = таблица (n + 1) x (W + 1), заполненная нулями # Базисные случаи
    for i = 1; i <= n; i++:
        item = i - 1 # Предмет, добавляемый на этом шаге
        for j = 1; j <= W; j++:
            d[i][j] = d[i - 1][j] # Вариант без очередного предмета
            if w[item] <= j and d[i - 1][j - w[item]] + p[item] > d[i][j]:
                # Взять очередной предмет оказалось выгоднее
                d[i][j] = d[i - 1][j - w[item]] + p[item]
    return d[n][W]
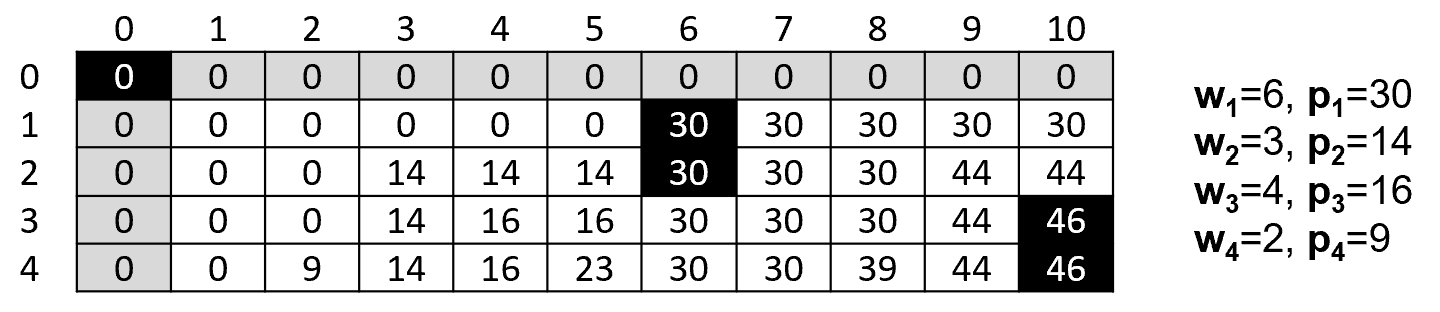
На рисунке 23 приведён пример таблицы для набора из 4 предметов и рюкзака вместимостью 10. Первая строка и первый столбец заполняются нулями предварительно – это базисные случаи. Затем ячейки таблицы заполняются в направлении сверху вниз слева направо (по столбцам или построчно). Обращение за границы массива означает, что такой вариант укладки невозможен. Для восстановления структуры решения нужно двигаться от нижней правой ячейки вверх и следовать логике, обратной рекуррентному соотношению. Когда в соседних ячейках столбца значение ценности изменилось, это значит, что введение очередного предмета позволило найти более удачную комбинацию, т.е. он является частью решения. Затем нужно переместиться влево на величину размера этого предмета и продолжить двигаться вверх уже по новому столбцу. Процедура продолжается, пока мы не достигнем левого верхнего угла. В данном примере максимальная ценность 46 достигается укладкой предметов 1 и 3.
Временная сложность этого алгоритма – . Она является псевдополиномиальной, поскольку полиномиальная зависимость имеет место от числового значения , тогда как размер входа для представления (бинарное представление) пропорционален . Если ограничено некоторым полиномом от , то становится полиномиальной сложностью относительно размера входа.
Задача о рюкзаке – хрестоматийная иллюстрация упомянутого ранее приёма сжатия размерности. Заметим, что при заполнении i-й строки таблицы используется только строка . Значит, хранить всю таблицу размера не требуется – достаточно одного массива длины , обновляемого на месте. Единственная тонкость заключается в порядке обхода: двигаться по вместимости нужно в сторону убывания, иначе ячейка к моменту обращения окажется уже перезаписанной значением текущей строки, что равносильно повторному взятию i-го предмета.
def knapsack_compressed(w, p, n, W):
    d = массив длины (W + 1), заполненный нулями
    for i = 0; i < n; i++:
        # Обратный порядок гарантирует, что d[j - w[i]] всё ещё
        # содержит значение, полученное без i-го предмета
        for j = W; j >= w[i]; j--:
            if d[j - w[i]] + p[i] > d[j]:
                d[j] = d[j - w[i]] + p[i]
    return d[W]
Расход памяти снижается с до при неизменной временной сложности. Платой становится невозможность восстановить структуру решения: сжатый массив хранит только итоговые ценности, но не историю выбора. Любопытно, что прямой порядок обхода в этом же коде решал бы другую задачу – о рюкзаке с неограниченным числом экземпляров каждого предмета, ведь тогда ячейка уже учитывала бы i-й предмет.
Вернёмся к задаче о размене, но немного её переформулируем. Пусть необходимо подсчитать общее число способов, которыми можно разменять заданную сумму. Будем строить динамику по двум параметрам, аналогичным тем, что вводились в задаче о рюкзаке. Дело в том, что задача о размене очень близка к задаче о рюкзаке. Сумма – аналог вместимости, а номиналы монет – это те же предметы, только неуникальные. Другое отличие в том, что нам нужно подсчитывать общее число комбинаций, а не искать оптимальную. Это в том числе влияет на функцию агрегирования: вместо очевидно необходимо суммирование (внесение нового номинала добавляет новые комбинации). Беря это всё во внимание, получаем такую постановку:
Во втором слагаемом (20) в силу неуникальности экземпляров монет мы обращаемся к решению, рассматривающему множество номиналов, включая i-й, хоть и предполагается, что такая монета уже положена (она может быть положена неоднократно). В базисном случае (22) число способов равно 1, а не 0, потому что существует ровно один способ выдать нулевую сумму – ничего не дать.
Динамическое программирование является очень популярным прикладным способом точного решения множества задач. Особенно комбинаторных, включая их оптимизационные постановки. Этот метод часто позволяет получить удобоваримую сложность по времени за счёт лишних трат по памяти (хранение заполняемых таблиц или кеша).
7.6. Метод преобразования задачи
Ещё одна категория методов заключается в различных преобразованиях исходной задачи так, чтобы она легче поддавалась решению. Можно выделить три разновидности таких преобразований: упрощение экземпляра, изменение представления и приведение задачи.
Пусть дана задача с входом . Общая схема подхода:
- построить преобразование , получив новый экземпляр ;
- решить преобразованную задачу известным алгоритмом ;
- если ответ имеет иной формат – применить обратное преобразование ;
- получить ответ исходной задачи: .
Такой подход оправдан, если преобразованный экземпляр позволяет получить корректное решение для , и стоимость преобразования плюс стоимость решения новой задачи действительно лучше или практичнее альтернатив.
Упрощение экземпляра предполагает преобразование в более простой или более удобный для решения экземпляр той же задачи. Например, предварительная сортировка последовательности упрощает проверку единственности элемента, вычисление моды, поиск, нахождение ближайших значений и многое другое. Другой пример – предварительное удаление лишних данных из входного экземпляра. Например, в приведённой ранее задаче о размене номиналы, которые больше выдаваемой суммы, рассматривать не имеет смысла. И их можно предварительно удалить из множества номиналов перед запуском решения.
При изменении представления те же данные помещаются в удобную структуру, т.е. меняется их представление в памяти. Например, многие операции со множеством выполняются гораздо эффективнее, если его элементы поместить в сбалансированное дерево, хеш-таблицу или кучу. Граф, представленный матрицей смежности, может быть рационально сконвертировать в списки смежности, если он достаточно разрежён и решение задачи требует постоянного обхода смежных узлов. Построение различных поисковых индексов по данным также можно отнести к этому методу.
Наконец, приём приведения задачи заключается в сведении изначальной к экземпляру другой задачи, для которой известен алгоритм решения. При обсуждении темы поиска потоков в транспортной сети мы упоминали метод решения задачи о назначениях, заключающийся в её приведении к экземпляру задачи о максимальном потоке минимальной стоимости. Задачи минимизации легко преобразуются в задачи максимизации и наоборот. Приём приведения одних экземпляров задач к другим также имеет фундаментальную значимость, т.к. на его основе строится вся теория классов сложности задач, о которой мы будем говорить далее.
7.7. Прочие подходы
Ещё один широкий класс подходов к решению задач заключается в выполнении поиска в пространстве возможных комбинаций. Сюда можно отнести алгоритмы планирования, основанные на алгоритмах поиска кратчайшего пути в графе, а также различные метаэвристические алгоритмы оптимизации, включая вариации локального поиска. Это довольно обширные темы, поэтому они будут подробно изложены в отдельных главах.
Также стоит упомянуть метод поиска с возвратом (бэктрекинг), который часто фигурирует в различных источниках. По своей сути он является частным случаем применения алгоритмов поиска (конкретно поиска в глубину) для решения комбинаторных задач. Потому чуть подробнее о нём будет сказано в главе о решении задач поиском в графе состояний.