12. Структуры для работы с многомерными данными
12.1. Общие сведения
Рассмотренные в теме словаря поисковые структуры предполагали единственность ключа, т.е. наличие у объектов атрибутов-идентификаторов, по которым и совершается поиск. Но что, если поиск производится по нескольким атрибутам? Например, у работника есть ФИО, возраст, стаж и т.д. Тогда можно представить многомерное пространство признаков, где каждая ось – поисковый атрибут, а каждый объект соответствует некой точке пространства. Другие примеры многомерных данных: географическая карта, трёхмерная сцена. Типичные запросы, которые могут осуществляться в многомерном пространстве:
- найти все объекты, попадающие в заданную область (диапазонный запрос);
- найти объекты, наиболее близкие к заданной точке (задача поиска ближайших соседей);
- найти объекты, пересекающиеся с заданным;
- найти первый объект, встреченный лучом, выпущенным из заданной точки.
Каждому типу запроса отвечает свой круг прикладных задач:
- диапазонный запрос – геоинформационные системы и базы данных: «какие объекты попадают в этот прямоугольник карты», «кто из сотрудников подходит по возрасту и стажу одновременно»;
- ближайшие соседи – рекомендательные системы, классификация, поиск по эмбеддингам;
- пересечение объектов – обнаружение столкновений в физических движках;
- пересечение с лучом – трассировка лучей, оружие с мгновенным попаданием (hitscan), выбор объекта курсором, трассировка звука; сюда же примыкает отсечение геометрии, не попавшей в поле зрения камеры.
Прямолинейное решение любого из этих запросов перебирает все объектов. При десятках тысяч объектов и десятках запросов на кадр это уже неприемлемо, а в трассировке лучей запросов миллионы на кадр. Поэтому используются поисковые индексы на специальных структурах, основанных на одном приёме: объекты объединяются в группы, и сначала делается грубая проверка относительно целой группы. Если результат отрицателен, то вся группа отбрасывается целиком, без единой проверки её содержимого.
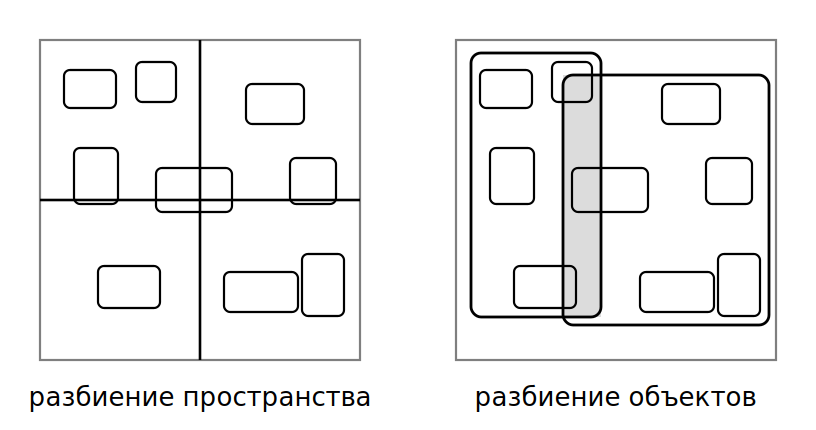
Группировать можно двумя способами (рисунок 43):
- разбиение пространства – режется само пространство, области не пересекаются и покрывают его целиком. Тогда легко понять, в какую область попала точка запроса, но объект, лежащий на границе, принадлежит сразу нескольким областям, и его приходится либо дублировать, либо разрезать;
- разбиение объектов – режется множество объектов, каждый попадает ровно в одну группу, а группа оборачивается ограничивающим объёмом. Дублирования нет, зато объёмы разных групп могут перекрываться, и запрос может быть вынужден спуститься сразу в несколько ветвей.
Ни один из способов не лучше другого. Они по-разному отвечают на вопрос, где допустить избыточность: в данных или в поиске.
12.2. Структуры разбиения пространства
Равномерная сетка – уже знакомый нам способ разбиения, при котором пространство нарезается на одинаковые ячейки, каждая хранит список попавших в неё объектов. Обращение к ячейке стоит , а построение всей сетки – . Соседи точки ищутся в её собственной ячейке и в смежных с ней.
Несмотря на примитивность, сетка широко применяется там, где сцена перестраивается каждый кадр: в широкой фазе обнаружения столкновений, в поиске соседей для роевых моделей и систем частиц. Её сильная сторона в том, что построение обходится дешевле любого дерева, а при равномерно разбросанных объектах качество разбиения не хуже. Однако слабостью являются неоднородные сцены: если объекты собраны в одном углу, большинство ячеек пусты, а всю работу делает одна. Другая проблема – выбор размера ячейки. Мелкие ячейки означают много памяти и попадание объекта сразу в несколько ячеек, крупные – длинные списки и перебор внутри ячейки. Хранить сетку массивом можно, только если мир ограничен. Для открытых миров ячейки кладут в хеш-таблицу по индексу (пространственное хеширование), и тогда память тратится только на непустые ячейки.
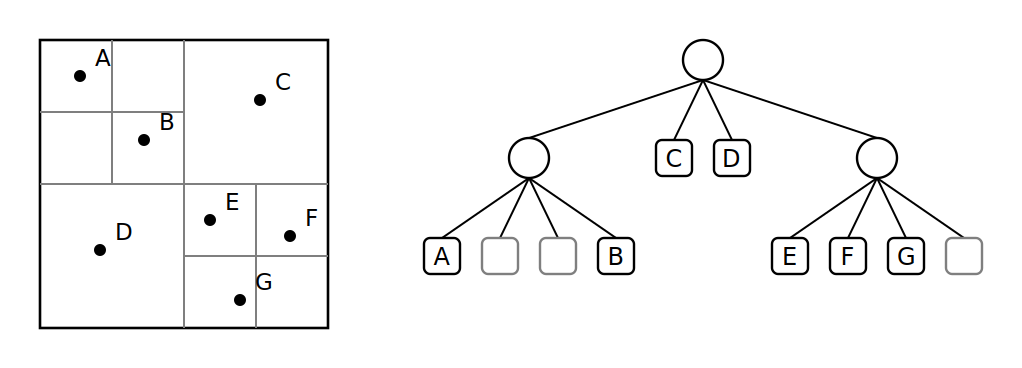
Квадродерево (quadtree, Финкель и Бентли, 1974) снимает проблему неоднородности: это та же сетка, но адаптивная. Квадрат делится на четыре одинаковых квадранта, каждый из них при необходимости снова на четыре (рисунок 44), и так до тех пор, пока в ячейке не останется мало объектов либо не будет достигнут предел глубины. Там, где пусто, дерево не ветвится вовсе. Трёхмерный аналог с делением на восемь частей называется октодеревом (octree).
Объект, не помещающийся в одну ячейку, может храниться:
- только в листьях – тогда объект дублируется во все листья, которые он задевает, и при обходе его нужно не забыть отсеять от повторной обработки;
- в наименьшем узле, целиком его содержащем – дублирования нет, но крупные объекты оседают у корня, и запрос обязан проверять содержимое всех узлов на своём пути, а не только листьев.
Применяют квадро- и октодеревья там, где ценна сама иерархия уровней детализации: представление изображений (однородная область не дробится дальше), уровни детализации ландшафта, разрежённые воксельные октодеревья, отсечение невидимой геометрии.
kD-дерево (k-d tree, Бентли, 1975) делит пространство не на равные части, а надвое по одной координате. Каждый внутренний узел задаёт гиперплоскость, перпендикулярную одной из осей. Дерево бинарное, и, в отличие от квадродерева, положение плоскости выбирается по данным, а не геометрически. Ось разделения либо чередуется по уровням, либо берётся самая широкая сторона текущей области. Положение делящей гиперплоскости обычно определяется медианой координат (тогда дерево сбалансировано) либо серединой области (тогда ячейки правильнее по форме). При трассировке лучей его можно подбирать эвристикой площади поверхности, о чём будет сказано далее в контексте BVH.
Построение сводится к сортировке точек вдоль каждой оси и рекурсивному делению пополам, что при измерениях даёт по времени и по памяти.
Типичная задача, ради которой строят kD-дерево, – поиск ближайших соседей. Для этого недостаточно спуститься в лист, где лежит точка запроса, и перебрать его содержимое. Ближайший сосед может лежать в соседней ячейке. Поэтому, спустившись в лист и получив первого кандидата на расстоянии , мы поднимаемся обратно и в каждом узле смотрим, пересекает ли шар радиуса вокруг запроса плоскость этого узла. Если не пересекает, вторая половина поддерева отбрасывается целиком. Если пересекает, в неё придётся спуститься. По мере нахождения более близких кандидатов радиус сокращается, и отсечение работает всё лучше (рисунок 45).
def nearest(node, q, best):
    if node - листовой узел:
        for each p из точек узла:
            if dist(q, p) < dist(q, best):
                best = p
        return best
    # Сначала спускаемся в ту половину, где лежит сам запрос
    near, far = потомки node, ближний и дальний относительно q
    best = nearest(near, q, best)
    # Дальняя половина нужна, только если шар текущего радиуса пересёк плоскость
    if |q[node.axis] - node.split| < dist(q, best):
        best = nearest(far, q, best)
    return best
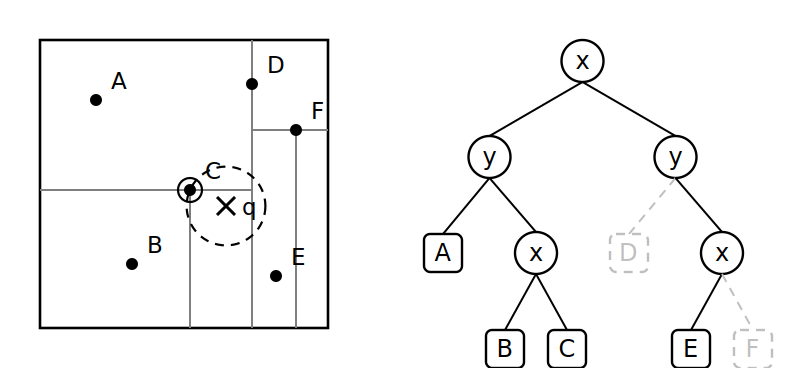
В среднем такой поиск обходится в , но гарантий нет: в худшем случае шар пересекает все плоскости и обход вырождается в перебор. Ровно это и происходит с ростом размерности – уже при нескольких десятках измерений kD-дерево не даёт выигрыша по сравнению с полным перебором (уже упоминавшееся проклятие размерности, пункт 10.5).
kD-дерево плохо переносит изменения. Удаление требует найти в поддереве замену по той же координате, по которой резал удаляемый узел, а после множества вставок дерево перекашивается и теряет свои свойства. Поэтому его почти всегда используют как статический индекс, а при изменении набора точек строят заново. Именно в таком виде оно применяется для поиска соседей в облаках точек и в библиотеках машинного обучения. Самая же массовая его реализация – блочное kD-дерево (BKD) в поисковом ядре Lucene, которым индексируется каждое числовое и географическое поле, а значит, и всё, что построено на Elasticsearch. Проблему обновлений оно обходит в том же духе: держит несколько статических деревьев и периодически сливает их.
BSP-дерево (binary space partitioning) получается, если снять с kD-дерева ограничение на ориентацию плоскостей. Применяется главным образом в работе с трёхмерной графикой, и секущая плоскость здесь задаётся плоскостью одного из полигонов. Полигоны, оказавшиеся по разные стороны, уходят в разные поддеревья, а полигон, пересечённый плоскостью, приходится физически разрезать надвое. Отсюда и цена: число полигонов растёт в процессе построения, а само построение стоит , поэтому дерево строят заранее, при сборке уровня, а не в рантайме. Термином BSP называют иногда и выровненное по осям разбиение. Например, именно в таком значении оно применяется при процедурной генерации комнат в играх.
Произвольные плоскости дают два свойства, недоступные выровненным по осям структурам. Первое – строгий порядок отрисовки. Для любого положения камеры сначала обходится дальнее поддерево, затем полигоны узла, затем ближнее. Сторона определяется положением камеры относительно плоскости узла. Это позволяет обходить полигоны от дальних к ближним и рисовать сцену, ничего не сортируя каждый кадр. Именно на этом были построены Doom (там BSP-дерево двумерное, по отрезкам стен) и Quake. Аппаратный буфер глубины задачу снял, и сегодня для порядка отрисовки BSP-дерево не нужно. Source 2, например, заменил унаследованное BSP-дерево на выровненное по осям дерево видимости.
Лист BSP-дерева – это точная выпуклая область, про которую известно, сплошная она или пустая. Не приближение, как ячейка сетки, а в точности та геометрия, что есть в сцене. Наклонную стену kD-дерево или октодерево представят лестницей из ячеек и в конце всё равно потребуют точной проверки, а BSP-дерево представляет её одной плоскостью. Поэтому проверка столкновения сводится к трассировке отрезка по дереву: точка пересечения со стеной находится прямо в узлах, без единой проверки против полигонов.
def trace(node, p1, p2):
    # Ищет первую точку, в которой отрезок p1p2 входит в сплошную область
    if node - листовой узел:
        if node - сплошной:
            return p1                  # отрезок уже внутри стены
        return нет столкновения
    d1 = знаковое расстояние от p1 до плоскости node
    d2 = знаковое расстояние от p2 до плоскости node
    # Отрезок целиком по одну сторону - спускаемся только в эту половину
    if d1 >= 0 and d2 >= 0:
        return trace(node.front, p1, p2)
    if d1 < 0 and d2 < 0:
        return trace(node.back, p1, p2)
    # Иначе режем отрезок точкой его пересечения с плоскостью
    mid = p1 + (p2 - p1) * d1 / (d1 - d2)
    near, far = node.front, node.back
    if d1 < 0:
        near, far = node.back, node.front
    # Ближняя половина проходится первой, поэтому найденное в ней - первое касание
    hit = trace(near, p1, mid)
    if hit != нет столкновения:
        return hit
    return trace(far, mid, p2)
Приведённая процедура трассирует точку. Для объекта с габаритами дерево строят заранее по плоскостям, раздвинутым наружу на его размер, и тогда та же процедура работает и для него. На этом же свойстве держатся предрасчёт множеств потенциально видимой геометрии (PVS) и булевы операции над телами в конструктивной блочной геометрии, где классификация полигонов относительно плоскостей граней и составляет суть алгоритма.
12.3. Структуры разбиения объектов
При втором способе группировки множество объектов разбивается на подмножества, и каждое оборачивается ограничивающим объёмом – простой фигурой, целиком содержащей всё её содержимое. Группы объединяются в дерево, где объём родителя содержит объёмы детей. Каждый объект лежит ровно в одном листе, поэтому ни дублировать, ни разрезать ничего не приходится. Платой становится перекрытие: объёмы соседних узлов могут накладываться, и запрос, попавший в область перекрытия, вынужден спуститься в обе ветви.
Форма объёма – отдельный компромисс между точностью облегания и стоимостью проверки:
- сфера – проверка дешевле всего, форма не меняется при вращении объекта, но аппроксимация объектов грубая;
- параллелепипед, выровненный по осям (Axis-Aligned Bounding Box, AABB) – проверка сводится к сравнению координат по каждой оси, объединение двух AABB считается поэлементным минимумом и максимумом; при вращении объекта требует пересчёта. Именно AABB применяется в подавляющем большинстве реализаций;
- произвольно ориентированный параллелепипед (OBB) и k-DOP – облегают плотнее, но проверка заметно дороже.
Иерархия ограничивающих объёмов (Bounding Volume Hierarchy, BVH) – бинарное дерево такого рода над объектами сцены. Строится сверху вниз: берётся ограничивающий объём всего множества, множество делится на две части, к каждой рекурсивно применяется то же самое. Деление прекращают, когда в группе остаётся мало объектов.
Качество BVH определяется принципом разделения. Простые стратегии режут по медиане вдоль самой длинной оси объёма либо по центрам объектов. Практический стандарт – эвристика площади поверхности (Surface Area Heuristic, SAH), прямо оценивающая ожидаемую стоимость обхода при трассировке луча:
Здесь – площадь поверхности объёма родителя, и – площади объёмов детей, – число объектов в узле, и – числа объектов в его детях, – стоимость одного шага обхода, – стоимость одной проверки пересечения с объектом. Смысл отношения площадей в том, что для случайного луча, попавшего в родителя, вероятность попасть и в ребёнка пропорциональна отношению площадей их поверхностей. Перебирая варианты деления и выбирая минимум , получают дерево, обход которого дёшев. Той же величиной задаётся и критерий остановки: если разбиение не снижает по сравнению со стоимостью прямого перебора содержимого узла , узел оставляют листом.
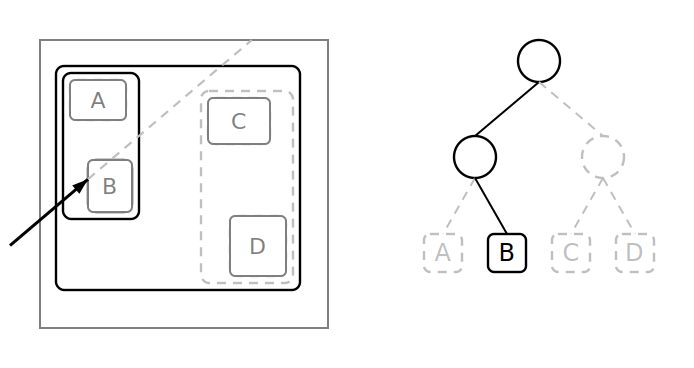
Обход при трассировке луча устроен так же, как отсечение в kD-дереве: если луч не пересекает объём узла, всё поддерево отбрасывается, а если пересекает объёмы обоих детей, спускаются сначала в ближний, и найденное там пересечение часто позволяет вовсе не заходить в дальний (рисунок 46).
BVH сегодня – основная структура в графике и физике. Аппаратная трассировка лучей (DirectX Raytracing, Vulkan Ray Tracing) построена именно на ней, причём двухуровневой: BVH внутри отдельного меша и BVH над экземплярами мешей в сцене. Такое разделение позволяет двигать и копировать объекты, не перестраивая ничего у них внутри. Физические движки держат динамическое AABB-дерево для широкой фазы поиска столкновений: оно отвечает на вопрос, какие пары объектов вообще могут пересекаться, а точная проверка выполняется уже только для них. Для анимированных сцен дерево обычно не перестраивают целиком, а обновляют объёмы снизу вверх (refit), полностью перестраивая лишь изредка, когда качество дерева успевает деградировать.
R-дерево (Гуттман, 1984) – та же идея, но выросшая из задач баз данных. Это B-дерево, обобщённое на прямоугольники: каждая запись узла – пара «минимальный ограничивающий прямоугольник (MBR) и ссылка», записи листьев ссылаются на объекты, записи внутренних узлов – на дочерние узлы. От B-дерева наследуются и ограничения: в узле от до записей, все листья на одном уровне, дерево сбалансировано (рисунок 47).
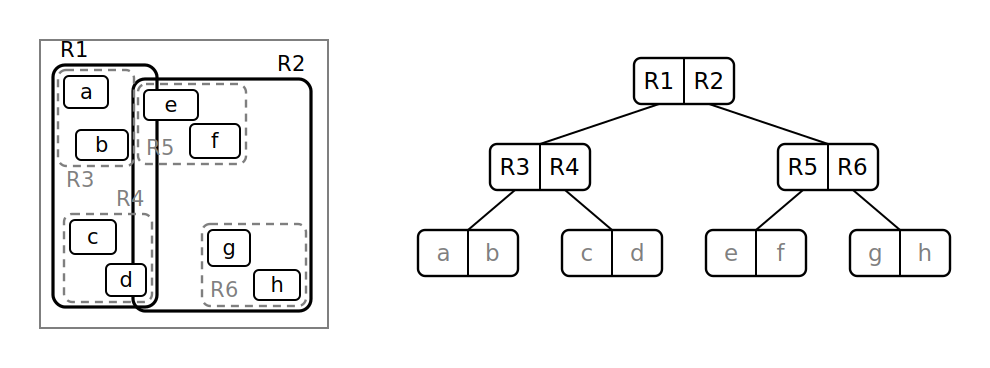
R-дерево проектировалось для долговременной памяти: узел занимает одну страницу, поэтому высота дерева – это число обращений к диску на запрос, и она не превосходит .
При поиске происходит спуск во всех детей, чьи MBR пересекают область запроса. Оценка сложности зависит от перекрытия: если над областью запроса прямоугольники не накладываются, она составляет ; если накладываются все, обход вырождается в перебор . Поэтому операции на R-дереве реализованы так, чтобы минимизировать перекрытия.
При вставке новый объект спускается в тот лист, чей прямоугольник придётся расширить меньше всего:
def choose_leaf(node, box):
    while node не является листовым узлом:
        # Расширение MBR - это то, чем мы платим за размещение объекта здесь
        выбрать ребёнка child, дающего минимальный прирост площади MBR при добавлении box
        # При равных приростах побеждает тот, чей прямоугольник меньше
        node = child
    return node
При переполнении узла происходит его разделение. Объекты надо разложить на две группы так, чтобы суммарная площадь получившихся прямоугольников и их взаимное перекрытие были как можно меньше, а это разные цели, и они конфликтуют. Перебирать все разбиения слишком дорого, поэтому применяют эвристики:
- квадратичный алгоритм берёт начальной парой две записи, которые расточительнее всего объединять в один прямоугольник, и дальше добавляет очередную запись в ту группу, чей прямоугольник от этого расширится меньше;
- линейный алгоритм выбирает начальную пару по наиболее разнесённым границам вдоль одной из осей и работает быстрее ценой качества.
Наиболее известны две модификации. R+-дерево запрещает перекрытие на одном уровне ценой того, что объект может храниться сразу в нескольких узлах, т.е. фактически переходит к разбиению пространства со всеми его издержками. R*-дерево остаётся в исходной схеме, но улучшает эвристики: при переполнении часть записей не разделяется, а удаляется из узла и вставляется в дерево заново (принудительная переустановка), что со временем распутывает неудачно сложившуюся структуру. Именно такая реализация стала фактическим стандартом. Находят здесь применение и кривые из пункта 12.2: в R-дереве Гильберта записи перед группировкой сортируются по номеру на кривой, что заметно уменьшает перекрытие.
Практическая значимость R-дерева в том, что оно стоит за пространственными запросами почти в любой СУБД: PostGIS реализует их поверх обобщённого индекса GiST в PostgreSQL, SQLite поставляет модуль R*Tree в виде виртуальной таблицы над теневыми таблицами, свои реализации есть в Oracle Spatial и MySQL. Когда приложение спрашивает «какие объекты попадают в этот участок карты» или «что есть в радиусе километра», работу выполняет R-дерево.
12.4. Выбор структуры
Таблица 8. Структуры для работы с многомерными данными
| Структура | Что разбивает | Построение | Обновление | Применение |
|---|---|---|---|---|
| Равномерная сетка | пространство | тривиально | однородные сцены, перестройка каждый кадр | |
| Квадро- и октодерево | пространство | легко | уровни детализации, воксели, изображения | |
| kD-дерево | пространство | плохо, перестраивают | ближайшие соседи в малой размерности | |
| BSP-дерево | пространство | только офлайн | точная геометрия: коллизии, PVS, CSG | |
| Кривые Мортона и Гильберта | пространство | как у обычного индекса | геоданные поверх одномерного индекса | |
| BVH | объекты | refit либо перестройка | трассировка лучей, широкая фаза физики | |
| R-дерево | объекты | полноценно динамическое | пространственные индексы в СУБД |
Описанные структуры во многом взаимозаменяемы, т.к. позволяют реализовать все основные операции: запросы по диапазону, поиск коллизий, трассировку луча и т.д. Поэтому выбор структуры почти всегда определяется не столько типом запроса, сколько тем, как часто меняются данные и где они лежат:
- пространственные запросы в базе данных – R-дерево: оно единственное из перечисленных рассчитано и на диск, и на постоянные изменения, и уже реализовано в СУБД, так что задача чаще всего сводится к созданию нужного индекса;
- трассировка лучей и широкая фаза физики – BVH, причём в трассировке альтернативы фактически нет: именно на неё рассчитана аппаратура;
- тысячи однородных мелких объектов, перестраиваемых каждый кадр, – равномерная сетка либо пространственное хеширование: любое дерево здесь проиграет на построении;
- статический набор точек и поиск соседей в небольшой размерности – kD-дерево;
- иерархия уровней детализации, воксели, изображения – квадро- или октодерево;
- точное представление геометрии (столкновения с уровнем, булевы операции) – BSP-дерево;
- геоданные там, где заводить специальную структуру не хочется, – нумерация кривой, заполняющей пространство.
Многомерная структура нужна не всегда. Например, планировщик СУБД нередко обходится без пространственного индекса: берёт два обычных индекса по отдельным столбцам, получает по каждому битовую карту подходящих строк и пересекает их. Многомерные структуры окупаются там, где запрос на независимые условия по осям не раскладывается: при поиске ближайшего, проверке пересечения тел, трассировке луча.
В реальных системах структуры комбинируют, а не выбирают одну. Двухуровневая схема аппаратной трассировки – это BVH над BVH. В играх поверх грубой сетки или октодерева сцены нередко живут отдельные деревья внутри каждого объекта. В СУБД пространственный индекс сочетается с обычными индексами по остальным атрибутам. Общее ограничение всех рассмотренных структур – они эффективны, лишь пока измерений немного. Для векторов высокой размерности, например для эмбеддингов, они вырождаются в перебор, и там переходят к приближённому поиску.